Высокопроизводительный универсальный GPU-фильтр деинтерлейсинга
Автор: Ким Бондаренко
Формат: Доклад
Уровень: Продвинутый
Дата: 2026.10.28
Что такое чересстрочная развёртка?
Несколько слов о чересстрочной развёртке.
Интерлейсинг и деинтерлейсинг появились ещё в эпоху аналогового телевидения. Чересстрочная развёртка — вовсе не устаревшая технология, которая лишь создаёт «гребёнку» на изображении и требует последующего исправления. На самом деле это весьма удачный приём, учитывающий особенности зрительного восприятия и позволяющий существенно сократить объём передаваемых данных.
Интерлейсинг одновременно решает две задачи. В динамичных сценах зритель воспринимает движение с частотой 50 обновлений в секунду, а в статичных — получает изображение с полным вертикальным разрешением, формируемое из двух полей с частотой 25 кадров в секунду. Далее будем рассматривать систему 50/25, хотя аналогичные принципы действуют и для 60/30, а также их вариаций.
Всё это работает благодаря особенностям кинескопных дисплеев и тому, как человеческое зрение воспринимает движение и детали изображения. Сам приём получил название «чересстрочная развёртка», поскольку соседние строки изображения передаются в разных полях.
Как это работает?
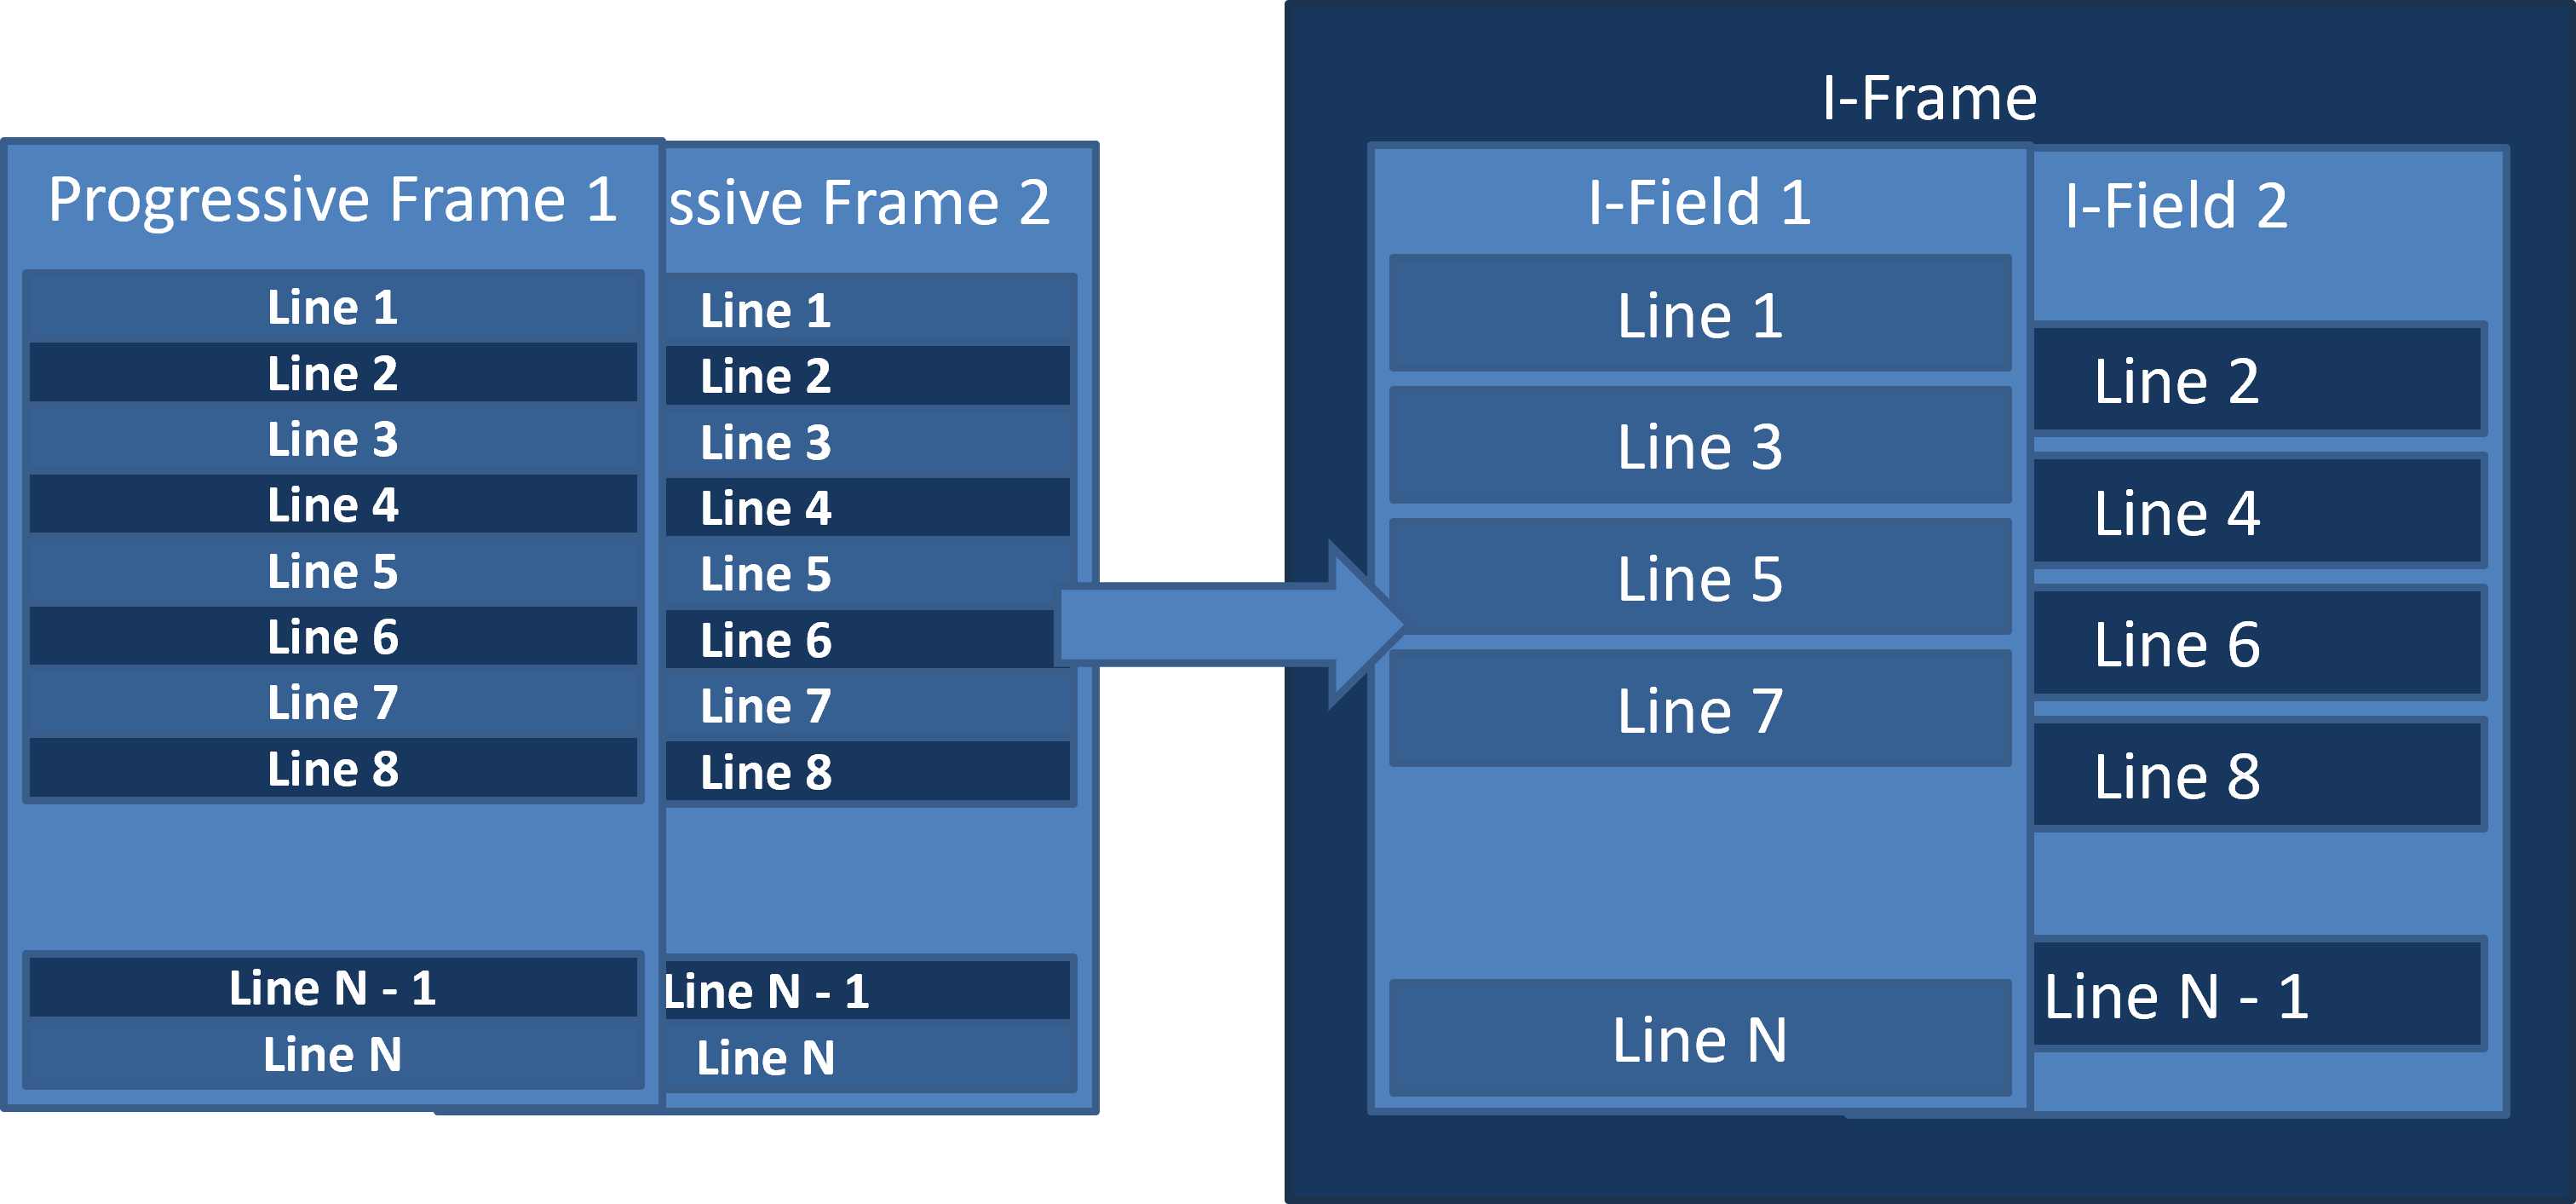
Принцип формирования чересстрочного видео довольно прост. Одно поле содержит нечётные строки изображения, следующее — чётные строки, полученные в другой момент времени. Остальные строки каждого исходного кадра отбрасываются. Из двух полей формируется один чересстрочный кадр. Его размеры совпадают с исходным прогрессивным кадром, но частота кадров уменьшается вдвое. Соответственно, вдвое сокращаются пиксельная скорость (pixel rate) и пропускная способность, необходимая для передачи несжатого видеопотока.
Чересстрочное видео может передаваться разными способами. В аналоговом телевидении изображение передавалось последовательно полями (полукадрами), строки которых чередовались на экране кинескопа. Например, в системе PAL/SECAM использовалось 625 строк на полный кадр, включая интервалы кадрового гашения, из них 576 строк относились к активному изображению. На полукадр приходилось 312 или 313 строк, а чётность количества строк в поле использовалась для определения чётности номера поля.
Цифровые форматы позволяют передавать чересстрочное видео как полными кадрами, содержащими оба поля, так и отдельными полями. В отличие от аналогового телевидения, здесь не нужны интервалы обратного хода электронного луча, а порядок полей задаётся явно или определяется форматом. Типичные размеры активного изображения — 576 строк для SD и 1080 строк для Full HD, соответственно по 288 и 540 строк на поле. На практике для нас это не имеет особого значения, так как из декодера практически всегда приходит полный чересстрочный кадр с частотой 25 кадров в секунду.
Чересстрочное видео принято обозначать строчной буквойi (interlaced), а прогрессивное — буквойp (progressive), например 1080i50, 1080p50 и 1080p25. Последнее число обозначает количество полей в секунду для чересстрочного видео или кадров в секунду для прогрессивного.
Как выглядит чересстрочный кадр?
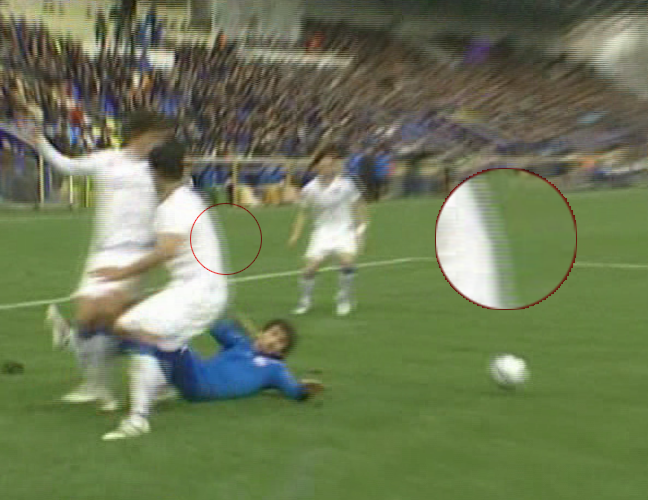
Подобный видеопоток знаком всем, кто использовал обычные видеопроигрыватели и контент из разных источников: характерная «гребёнка» и размытость изображения.
Многие пользователи недоумевали: зачем это вообще нужно в цифровом видео? Ответ предельно прост: по той же причине, что и в аналоговом телевидении, — для уменьшения pixel rate в вычислительно дорогостоящих операциях. Одной из самых дорогостоящих операций в цифровом видео исторически было (и отчасти остаётся) сжатие. То же касается и простых попиксельных операций, которые можно выполнять непосредственно над чересстрочными кадрами, например изменения яркости, контрастности и насыщенности.
Что такое Deinterlacing-фильтр?
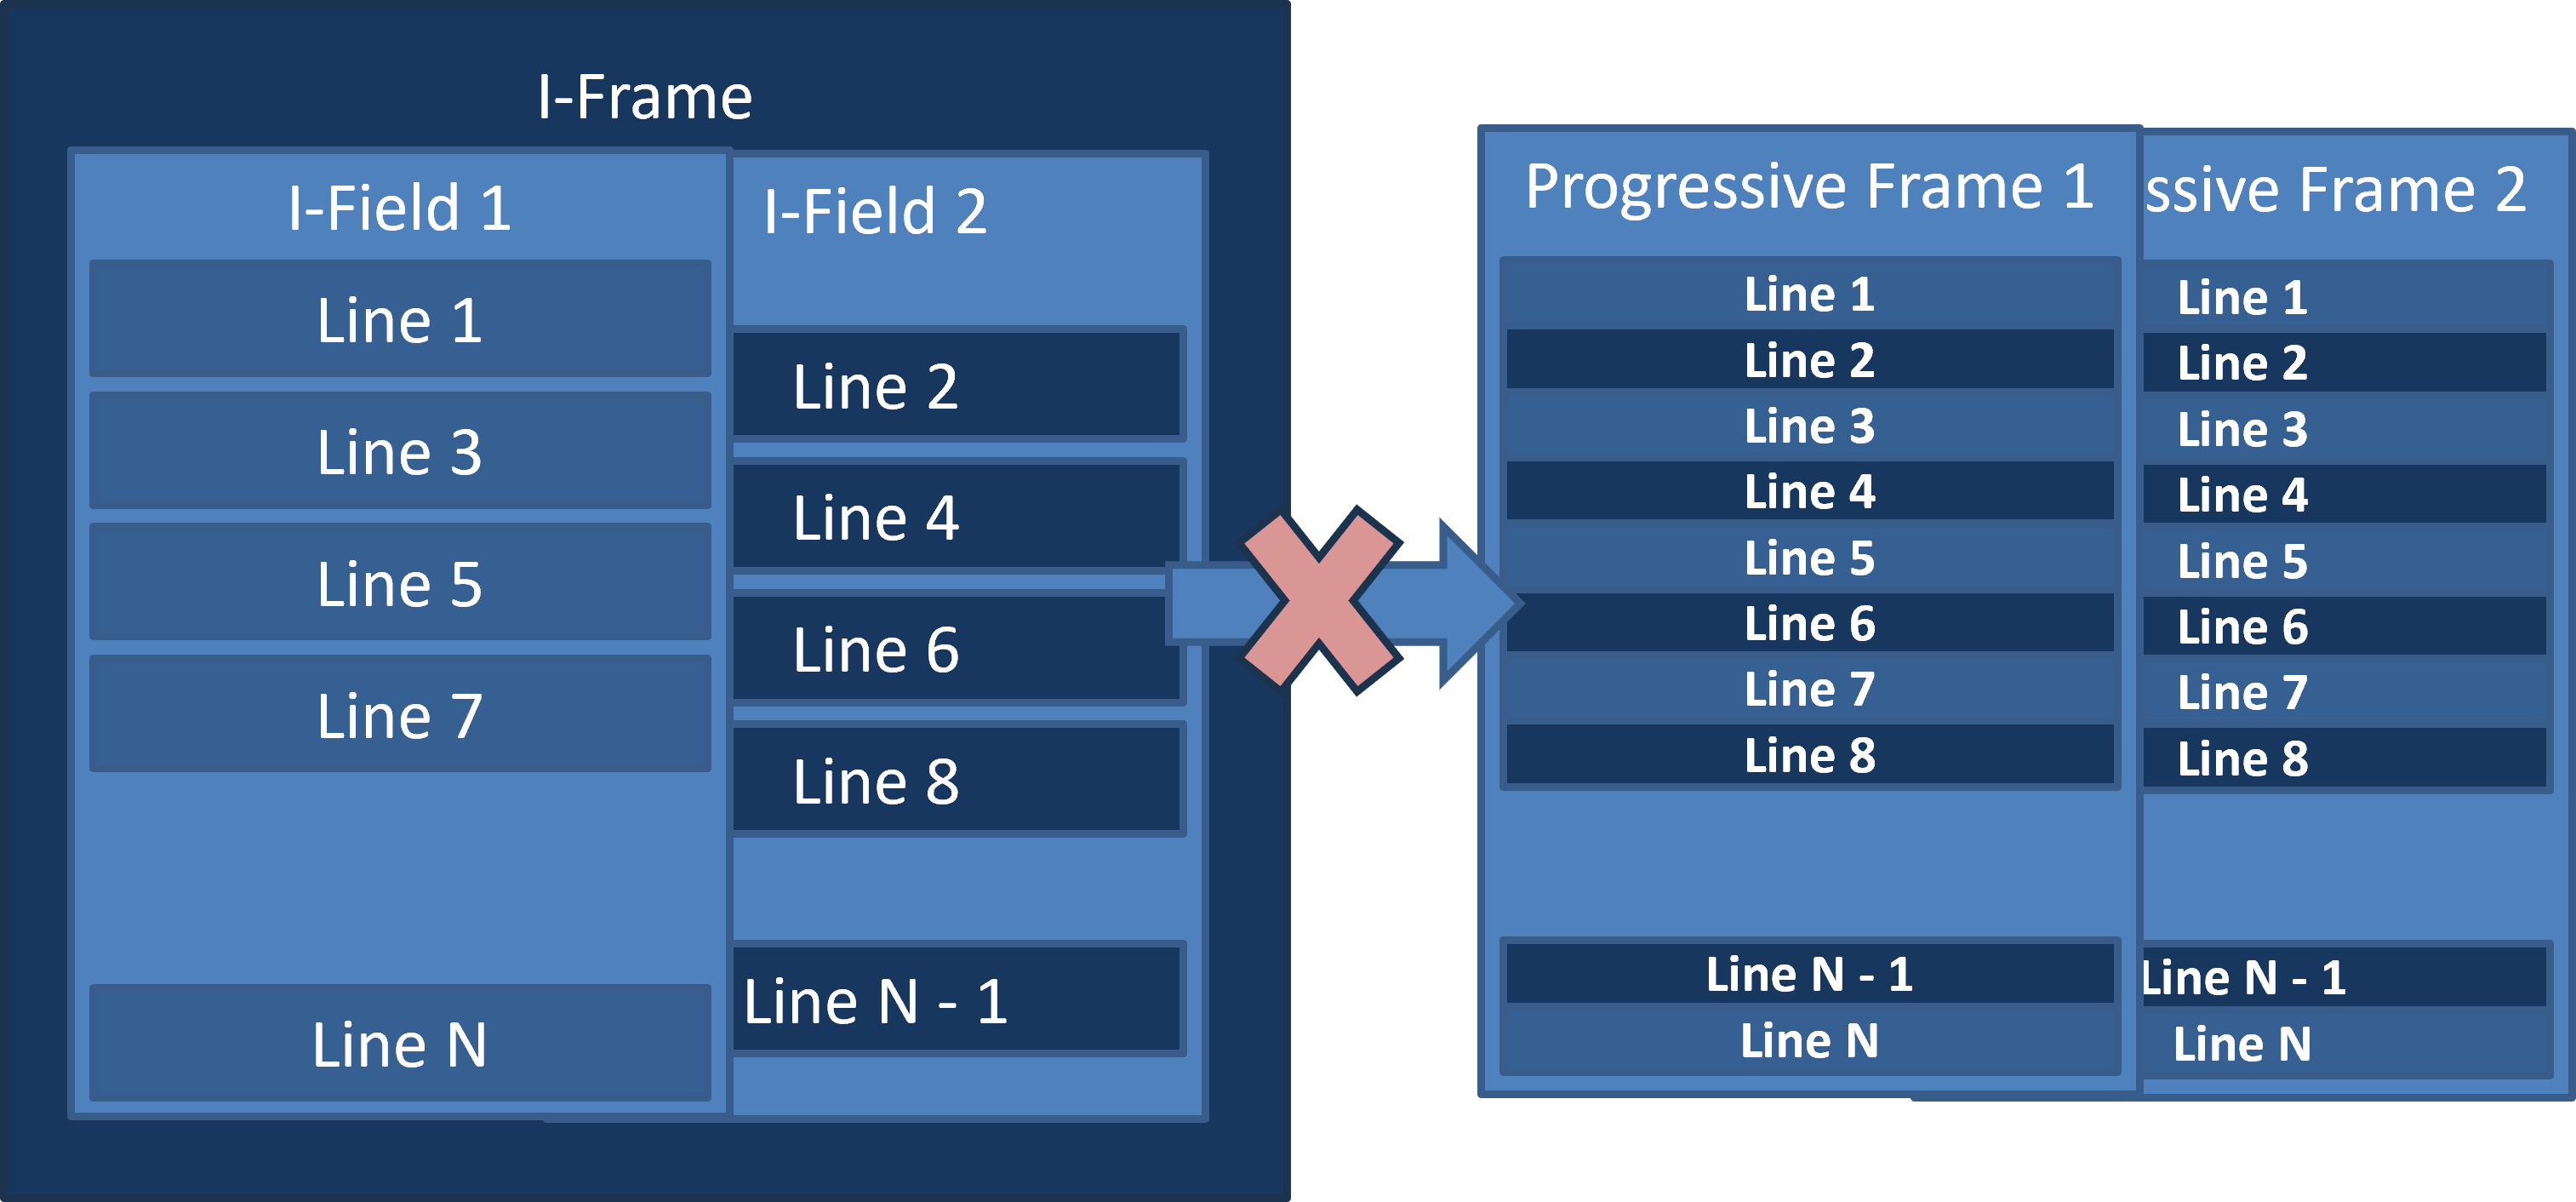
Обратная задача не так тривиальна, поскольку необходимо восстанавливать данные, которых нет в исходном потоке. Кроме того, на практике задача оказывается более разнообразной, чем просто восстановление отсутствующих строк.
Иногда на выходе нам не нужен динамичный поток 50 к/с — например, если последующая система просто не поддерживает такую частоту кадров. Так, многие OTT-сервисы обрабатывают и доставляют видео только с частотой 25 к/с. В этом случае задача сводится к удалению «гребёнки» с максимальным сохранением резкости и пространственной детализации изображения.
Иногда на выходе всё-таки требуется поток 50 к/с, но в исходном материале нет 50 различных кадров в секунду. Например, в поток может быть вставлен фрагмент с частотой 25 к/с — непосредственно в прогрессивном формате или в виде дублирующихся кадров внутри потока 50 к/с. В зависимости от настроек фильтр должен выдавать либо прогрессивный поток 25 к/с, либо поток 50 к/с.
Постановка задачи
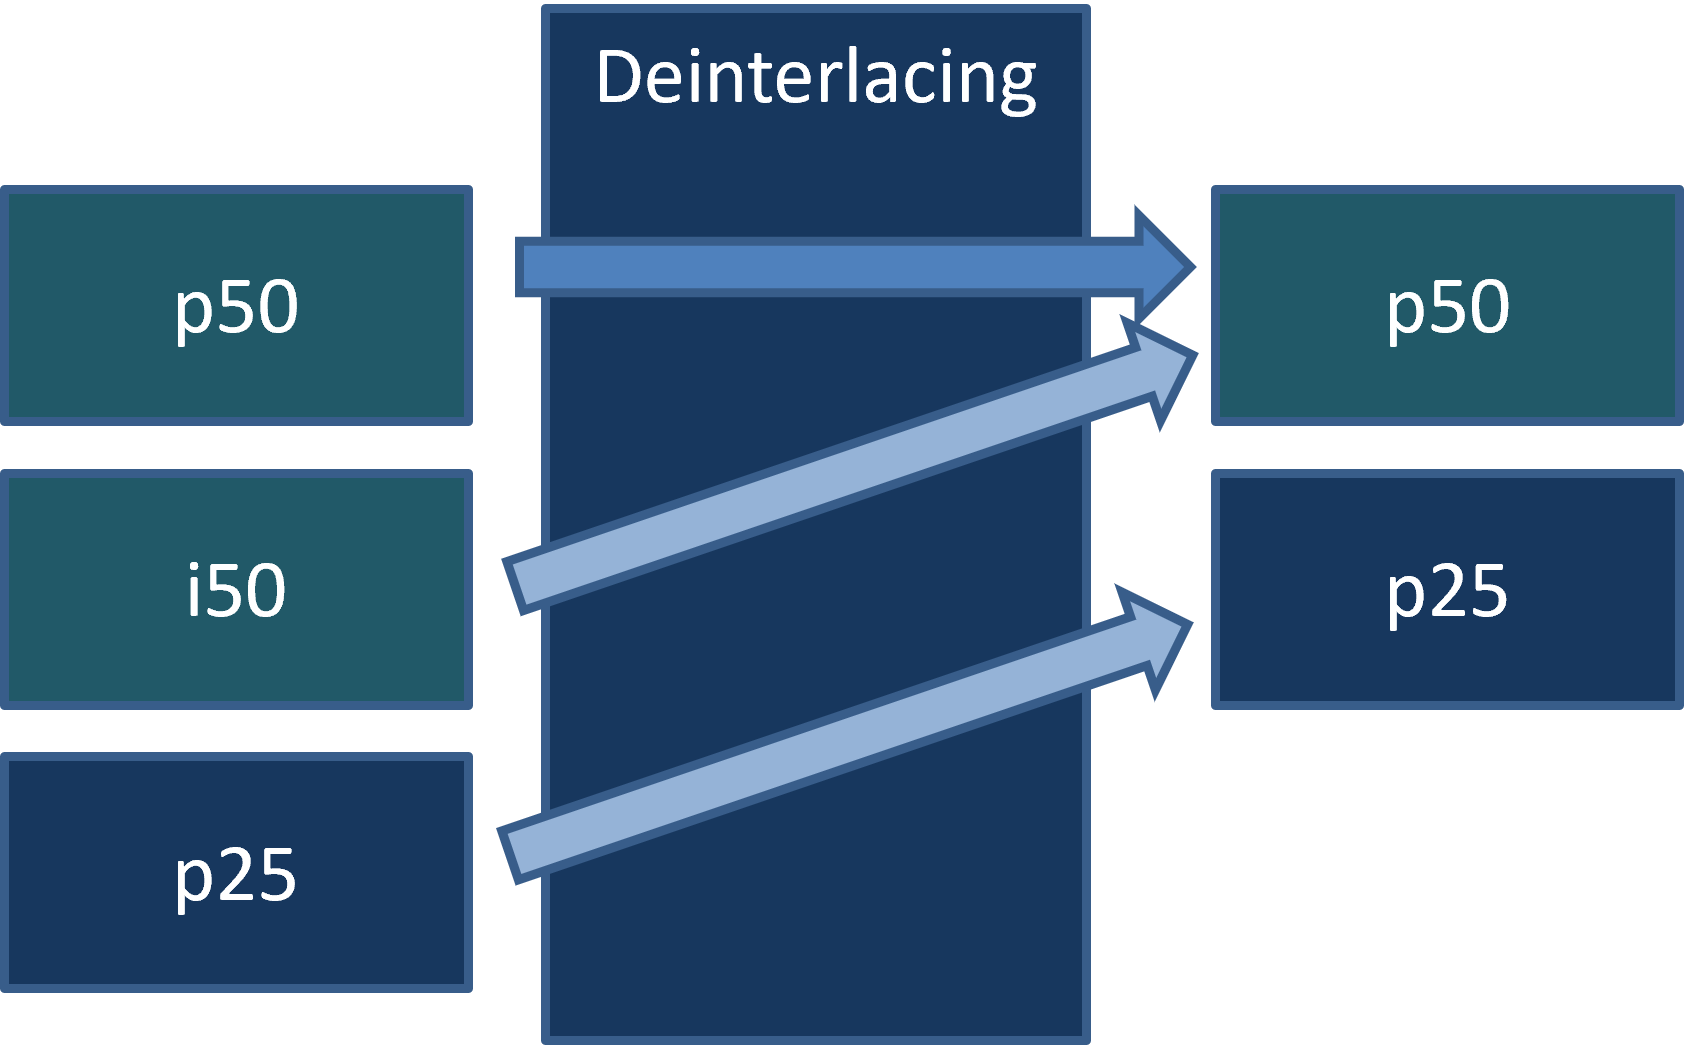
С точки зрения транскодера деинтерлейсинг-фильтр — это чёрный ящик, который в зависимости от настроек должен выдавать прогрессивный поток p25 или p50 либо автоматически переключаться между ними.
При этом он должен обрабатывать различные типы входных потоков и их смену в реальном времени. Поскольку на практике нельзя полагаться на маркировку кадров, фильтр должен иметь встроенные механизмы визуального анализа видеопотока.
При обнаружении прогрессивной развёртки фильтр не должен портить изображение ненужной эвристической обработкой. Вместо этого выходной кадр следует собирать непосредственно из исходных данных, без изменения пикселей.
Виды потоков
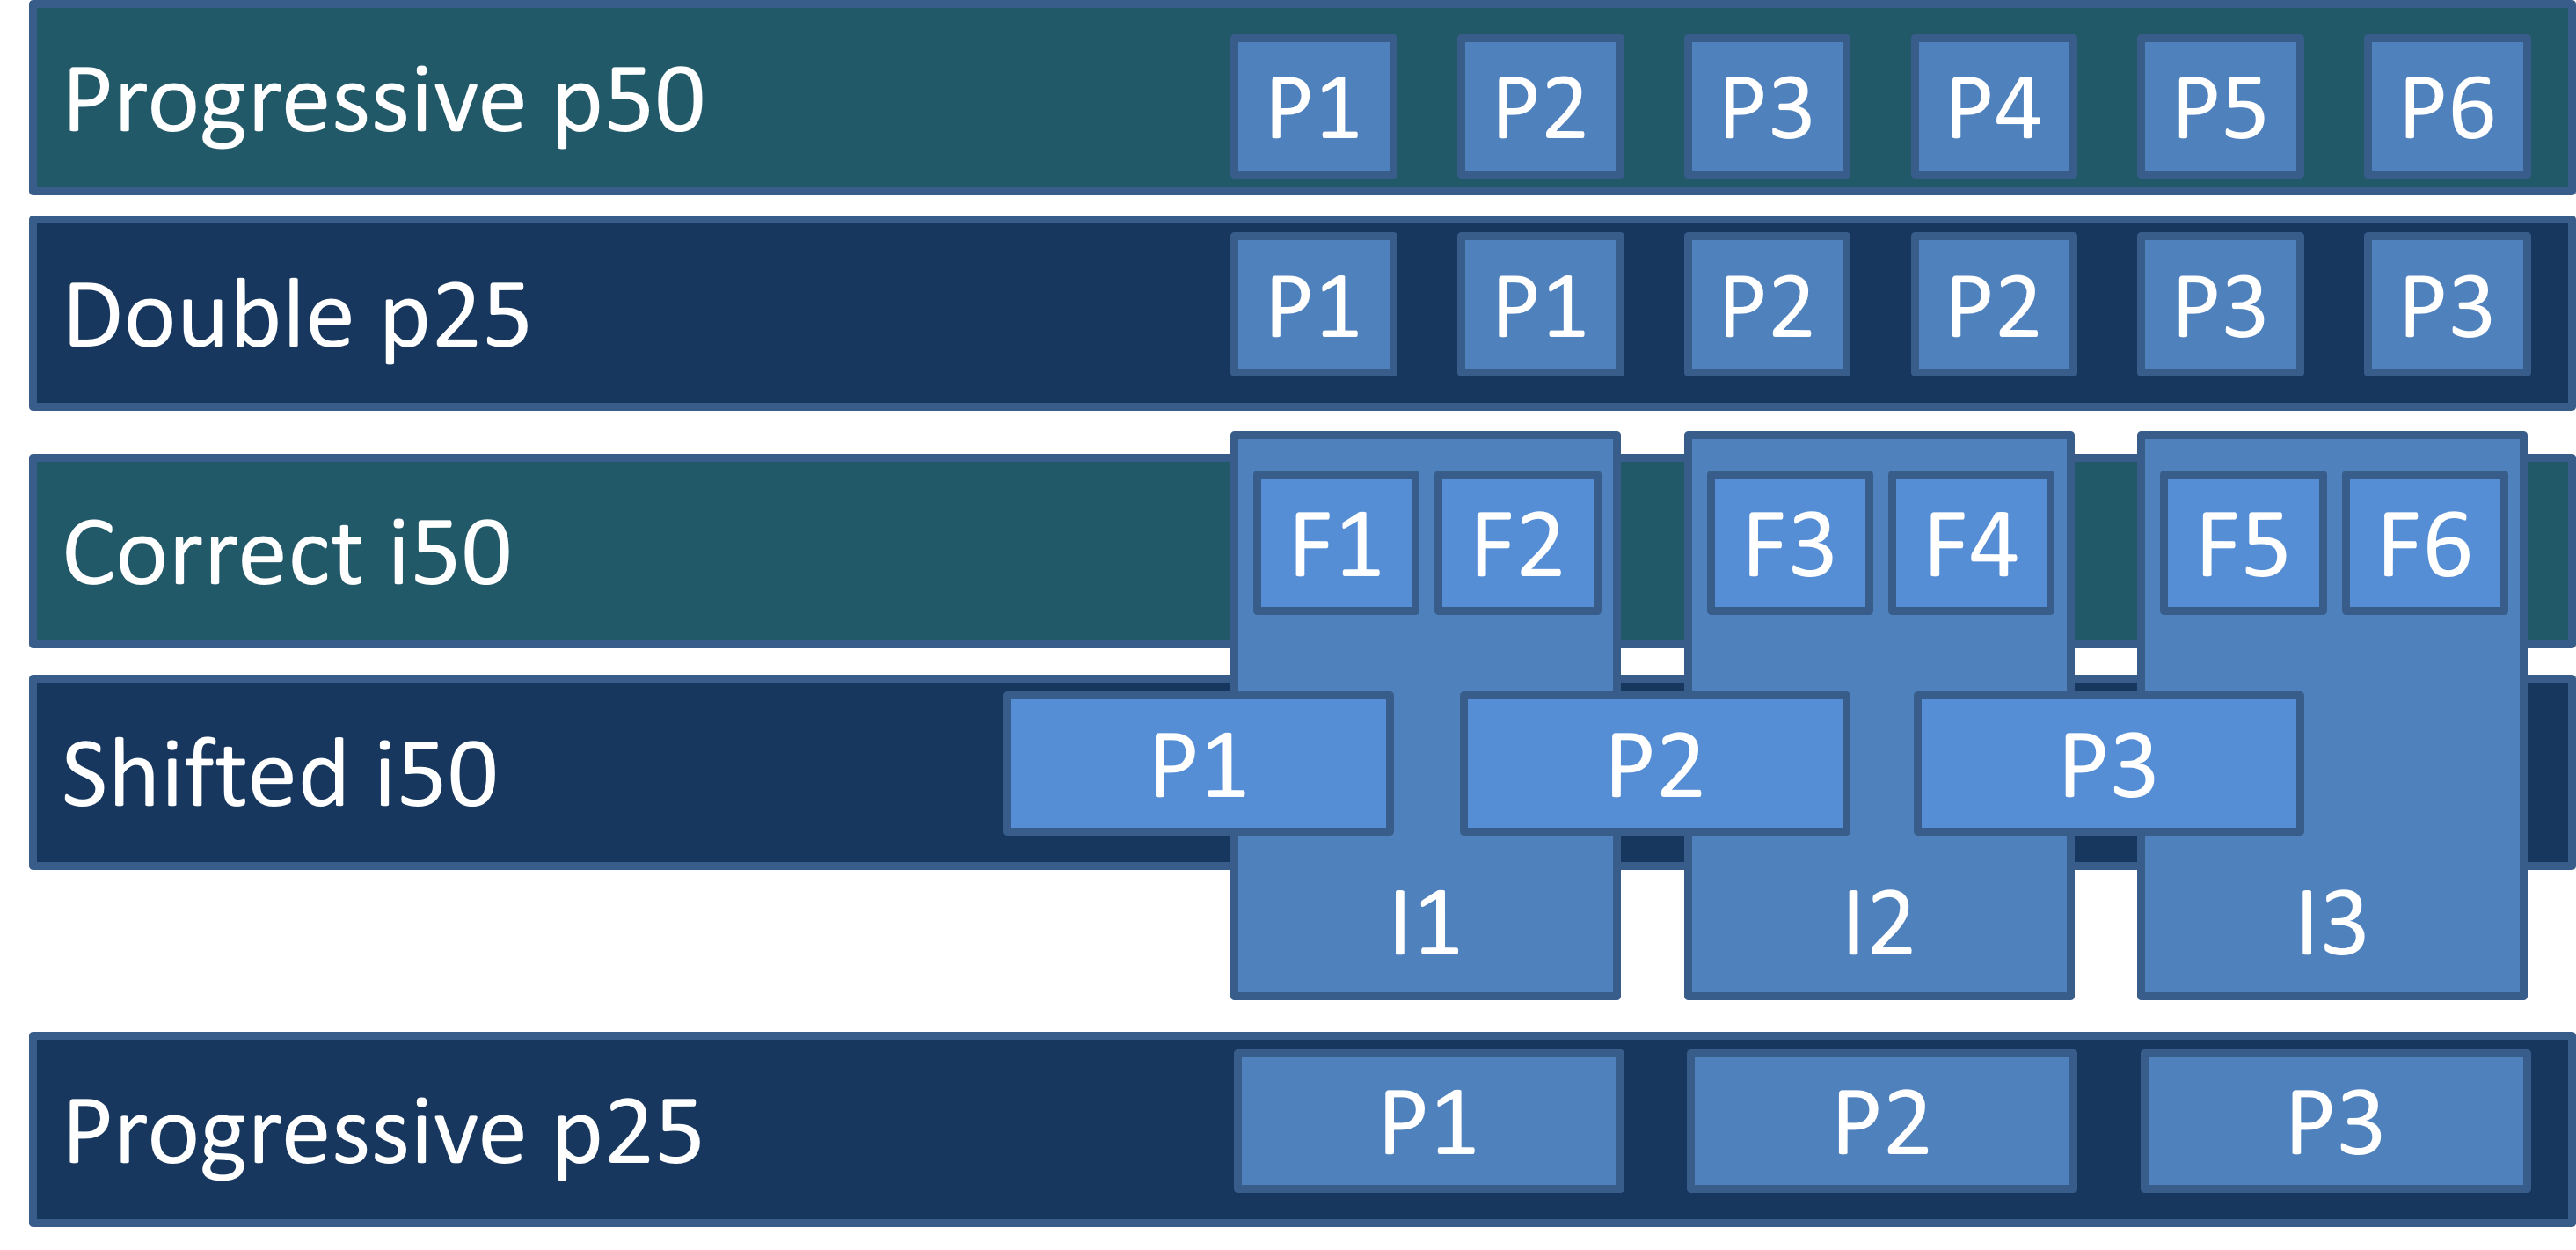
Какие типы потоков встречаются на практике? Когда мы начали разрабатывать этот фильтр, оказалось, что здесь нас ждёт настоящий зоопарк. После декодера у нас остаются только растровое изображение каждого кадра и временные метки. На информацию в метаданных, например о том, является ли поток чересстрочным или прогрессивным, на практике полагаться нельзя.
По временным меткам можно определить поток с частотой 50 кадров в секунду (первые две строки сверху). В этом случае вмешиваться в растровые данные кадров не нужно. Бывает корректный поток p50 — его нужно просто пропустить без изменений.
Однако нередко оказывается, что это вовсе не настоящий p50, а поток с попарно продублированными кадрами (вторая строка). При соответствующих настройках фильтр деинтерлейсинга должен распознать такой случай и удалить каждый второй кадр, оставив корректный поток 25 к/с.
Бывает классический чересстрочный поток i50 (третья строка сверху). Из него фильтр деинтерлейсинга должен восстановить полноценный прогрессивный поток p50.
Бывает и корректный прогрессивный поток p25 (последняя строка) — в этом случае фильтр вообще не должен изменять содержимое видео.
Встречается и более экзотический случай — так называемый смещённый интерлейсинг (четвёртая строка сверху). Внешне поток выглядит как обычный i50, однако после восстановления p50 оказывается, что соседние кадры попарно дублируются со смещением на одно поле (половину чересстрочного кадра) по времени. Ситуация неприятная, но её можно автоматически обнаружить и восстановить корректный поток p25.
Салатовым цветом выделены типы потоков, из которых можно восстановить видео с частотой 50 к/с. Синим — те, из которых можно восстановить только поток с частотой 25 к/с.
Небольшая демонстрация
А теперь — небольшой перекур. Посмотрим, как работает наш фильтр на практике.
Здесь показано одно и то же видео, обработанное двумя разными фильтрами: левая половина — результат работы нашего алгоритма, правая — другого достаточно хорошего быстрого адаптивного фильтра, сочетающего Bob-интерполяцию и Weave-реконструкцию.
Видео замедлено в два раза, чтобы разница в плавности движения в динамичных сценах была хорошо заметна.
Разница наиболее заметна в относительно статичных сценах и заключается в уменьшении высокочастотного мерцания контрастных областей. Особенно хорошо этот эффект проявляется при неподвижной камере и на графических элементах, наложенных поверх видео.
Определение наличия чересстрочной развёртки
Первым делом введём оценку чересстрочности кадра — вещественное число от 0 до 1.
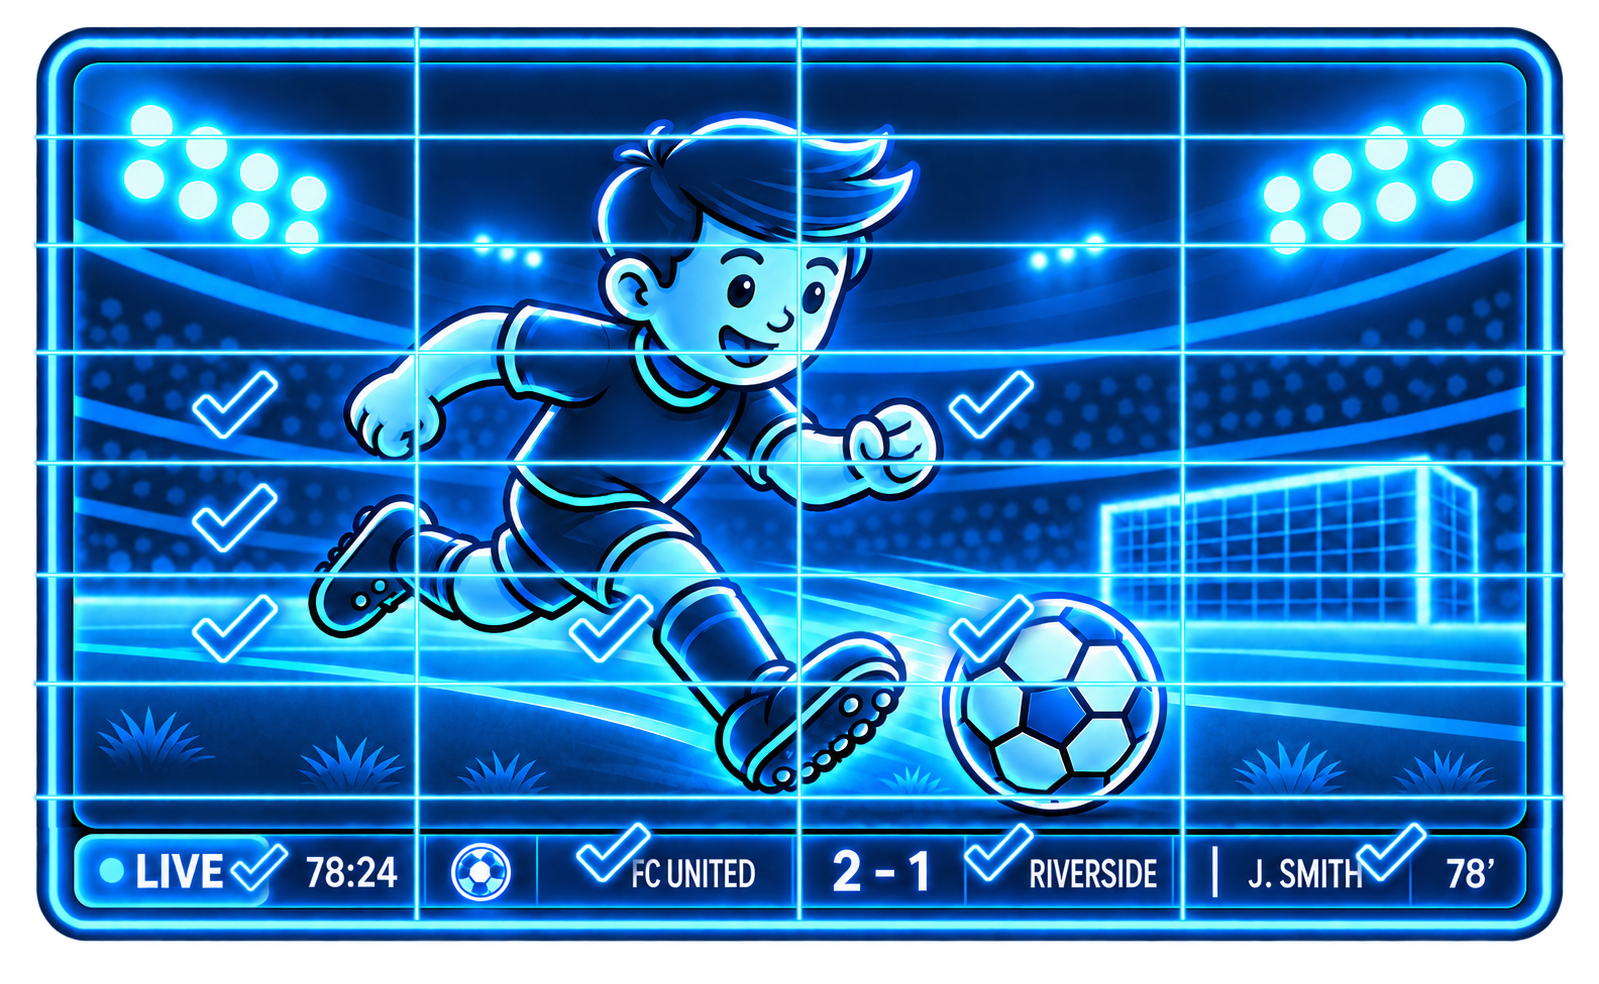
Для этого разобьём кадр на прямоугольные блоки и оценим чересстрочность каждого блока отдельно. В качестве оценки чересстрочности всего кадра возьмём максимальную оценку среди всех блоков.
Поскольку чересстрочность проявляется в движущихся областях, такой подход позволяет обнаруживать её локально, даже когда большая часть кадра относительно статична, но, например, в углу экрана присутствует бегущая строка или движется какой-либо объект.
Для Full HD неплохой вариант — разбивать кадр на сетку из 8 столбцов и 16 строк. Получаются вытянутые по горизонтали прямоугольные блоки, которые хорошо подходят для обнаружения бегущей строки.
Если оценка превышает фиксированное пороговое значение, кадр считается чересстрочным. В противном случае он предварительно считается прогрессивным.
Почему предварительно? При анализе потока следует избегать частого переключения режимов работы. Поэтому мы придерживаемся консервативного подхода и не переключаемся в прогрессивный режим сразу после исчезновения признаков чересстрочности. Обратное переключение, напротив, следует выполнять немедленно, поскольку пропущенная «гребёнка» создаёт хорошо заметные визуальные артефакты. Неплохая настройка — переключаться в прогрессивный режим только после 0,5–2 секунд отсутствия признаков чересстрочности.
Как вычислять оценку чересстрочности для блока?
Будем считать, что обычное изображение обладает высокой пространственной корреляцией. Это означает, что соседние пиксели, как правило, незначительно отличаются друг от друга.
В изображении с чересстрочной развёрткой объединены данные двух последовательных полей, полученных в разные моменты времени. При этом чётные строки соответствуют одному полю, а нечётные — другому. Пространственная корреляция пикселей внутри каждого поля обычно выше, чем корреляция в объединённом чересстрочном кадре.
Для каждого блока вычислим две меры пространственных различий между пикселями: f1 — для изображения с прогрессивной развёрткой и f2 — для изображения с чересстрочной. Поскольку мы будем сравнивать эти величины, нормировать их необязательно. Фактически f2 будет содержать суммарные различия между пикселями внутри двух полей. Хотя площадь каждого поля вдвое меньше площади прогрессивного кадра, их суммарная площадь такая же, поэтому делить результат на два не нужно.
Итоговую оценку a вычислим как отношение f1 к f2. Во избежание деления на ноль добавим в знаменатель небольшое значение эпсилон, равное 0.025f. Его точное значение не принципиально, поскольку оценка монотонно зависит и от f1 и от f2, а сравнивать её мы будем с единицей.
Для полностью статического видеоряда оценка aтакже будет статистически меньше единицы, поскольку корреляция между пикселями через одну позицию обычно ниже, чем между соседними пикселями.
Немного кода
Шейдер для вычисления сумм различий между пикселями
Texture2D<float> tx : register(t0);
RWTexture2D<float2> results : register(u0);

static const int N = 4; // num of 8x8 blocks to process at once

groupshared float2 shared_data[N*8];

[numthreads(8, N, 1)]
void CS(uint3 Gid : SV_GroupID,             // thread group id
        uint3 DTid : SV_DispatchThreadID,   // absolute thread position
        uint3 GTid : SV_GroupThreadID,      // thread position in thread group
        uint GI : SV_GroupIndex)            // thread group scalar index
{
    int2 res = int2(Gid.x*N + GTid.y, Gid.y);  // 8x8 block position

    int iX = GTid.x;    // x-position in block
    int iN = GTid.y;    // block index (0-3)

    int2 ixy0 = res*int2(8, 8);   // block coords

    // load initial data
    float v0 = 0;
    float v1 = tx[ixy0 + int2(iX, 0)];
    float v2 = tx[ixy0 + int2(iX, 1)];

    float2 result = float2(0, 0);
    [unroll] for (int y = 0; y < 8; y++)
    {
        // shift old data and load new data
        v0 = v1;
        v1 = v2;
        v2 = tx[ixy0 + int2(iX, y + 2)];

        // calculation
        result.x += abs(v0 - v1);
        result.y += abs(v0 - v2);
    }

    // store result
    int offset = iN*N;
    GROUP_SUM_VAR(iX, float2, results[res], result, shared_data, 8, offset);
}
Расшифровка хелпера для суммирования значений внутри ThreadGroup
// shared-memory sync
#define GROUP_SYNC GroupMemoryBarrierWithGroupSync();

// calculates sum of shared-memory array (pow of 2) at first element
#define GROUP_SUMO1(tid, S, shared_array1, N, offset, rest, pitch) \
{   \
    const uint i = (tid); \
    const uint ioffset = (uint)(offset); \
    [unroll] for (uint s = ((N) >> 1); (s > rest); s = (s >> 1)) \
    { \
        [branch] if (i < s) \
        { \
            shared_array1[ioffset + i*pitch] += \
                shared_array1[ioffset + (i + s)*pitch]; \
        } \
        GROUP_SYNC \
    } \
}

// calculates sum of shared-memory array (pow of 2) at dest
#define GROUP_SUMP(tid, S, dest, shared_array, N, offset, pitch) \
{   \
    GROUP_SUMO1(tid, S, shared_array, N, offset, 1, pitch); \
    [branch] if ((tid) == 0) \
        dest = shared_array[offset] + shared_array[offset + pitch]; \
}

// calculates sum of {source} and stores to <dest>
#define GROUP_SUM_VAR(tid, S, dest, source, shared_array, N, offset) \
    shared_array[tid + offset] = source; \
    GROUP_SYNC; \
    GROUP_SUMP(tid, S, dest, shared_array, N, 0, 1);
Здесь приведён код Compute-шейдера для быстрого вычисления обеих сумм различий между пикселями, f1 и f2, для блока размером 8×8 пикселей. Результат записывается в текстуру формата float2, разрешение которой в 8 раз меньше разрешения исходного изображения по каждой оси. Также приведён вспомогательный код для суммирования значений внутри ThreadGroup с использованием разделяемой памяти GPU (Shared Memory).
Анализируется только Y-плоскость яркости изображения. Цветовые плоскости UV в анализе не участвуют.
Код написан на языке HLSL. Он не зависит от производителя GPU и легко переносится на GLSL.
Расчёт для прямоугольной сетки
SComputeConstantsA g : register(b0);

Texture2D<float2> analData : register(t0);
RWStructuredBuffer<float> results: register(u0);

float getFactor(int2 p0, int2 p1)
{
	int npix = 0;
	float sum1 = 0, sum2 = 0;
	for (int y = p0.y; y < p1.y; y++) {
		for (int x = p0.x; x < p1.x; x++) {
			float2 data = analData[int2(x, y)];
			sum1 += data.x;
			sum2 += data.y;
			npix += (8*8);
		}
	}
	if (sum2 < npix*g.plus)
		sum2 = npix*g.plus;

	float factor = sum1/sum2;
	return factor;
}[numthreads(8, 8, 1)]
void CS(uint3 Gid : SV_GroupID, // thread group id
uint3 DTid : SV_DispatchThreadID, // absolute thread position
uint3 GTid : SV_GroupThreadID, // thread position in thread group
uint GI : SV_GroupIndex) // thread group scalar index
{
uint x = DTid.x;
uint y = DTid.y;
if ((x < g.matrix_x) && (y < g.matrix_y))
{
uint2 p0 = uint2(x*g.nsize_x/g.matrix_x,
y*g.nsize_y/g.matrix_y);
uint2 p1 = uint2((x + 1)*g.nsize_x/g.matrix_x,
(y + 1)*g.nsize_y/g.matrix_y);
results[y*g.matrix_x + x] = getFactor(p0, p1);
}
}
Тогда вычисление оценки чересстрочности для каждого прямоугольного блока на GPU становится тривиальным. Для этого достаточно аккуратно просуммировать различия из блоков 8×8, входящих в соответствующую область, вычислить отношение полученных сумм и записать оценку в буфер результатов. Продолжать вычисления на GPU особого смысла нет: при разбиении кадра на 16 строк и 8 столбцов получается всего 128 областей. Проще передать небольшой буфер на CPU, вычислить там максимальную оценку и принять высокоуровневое решение о деинтерлейсинге.
Случай Shifted p25
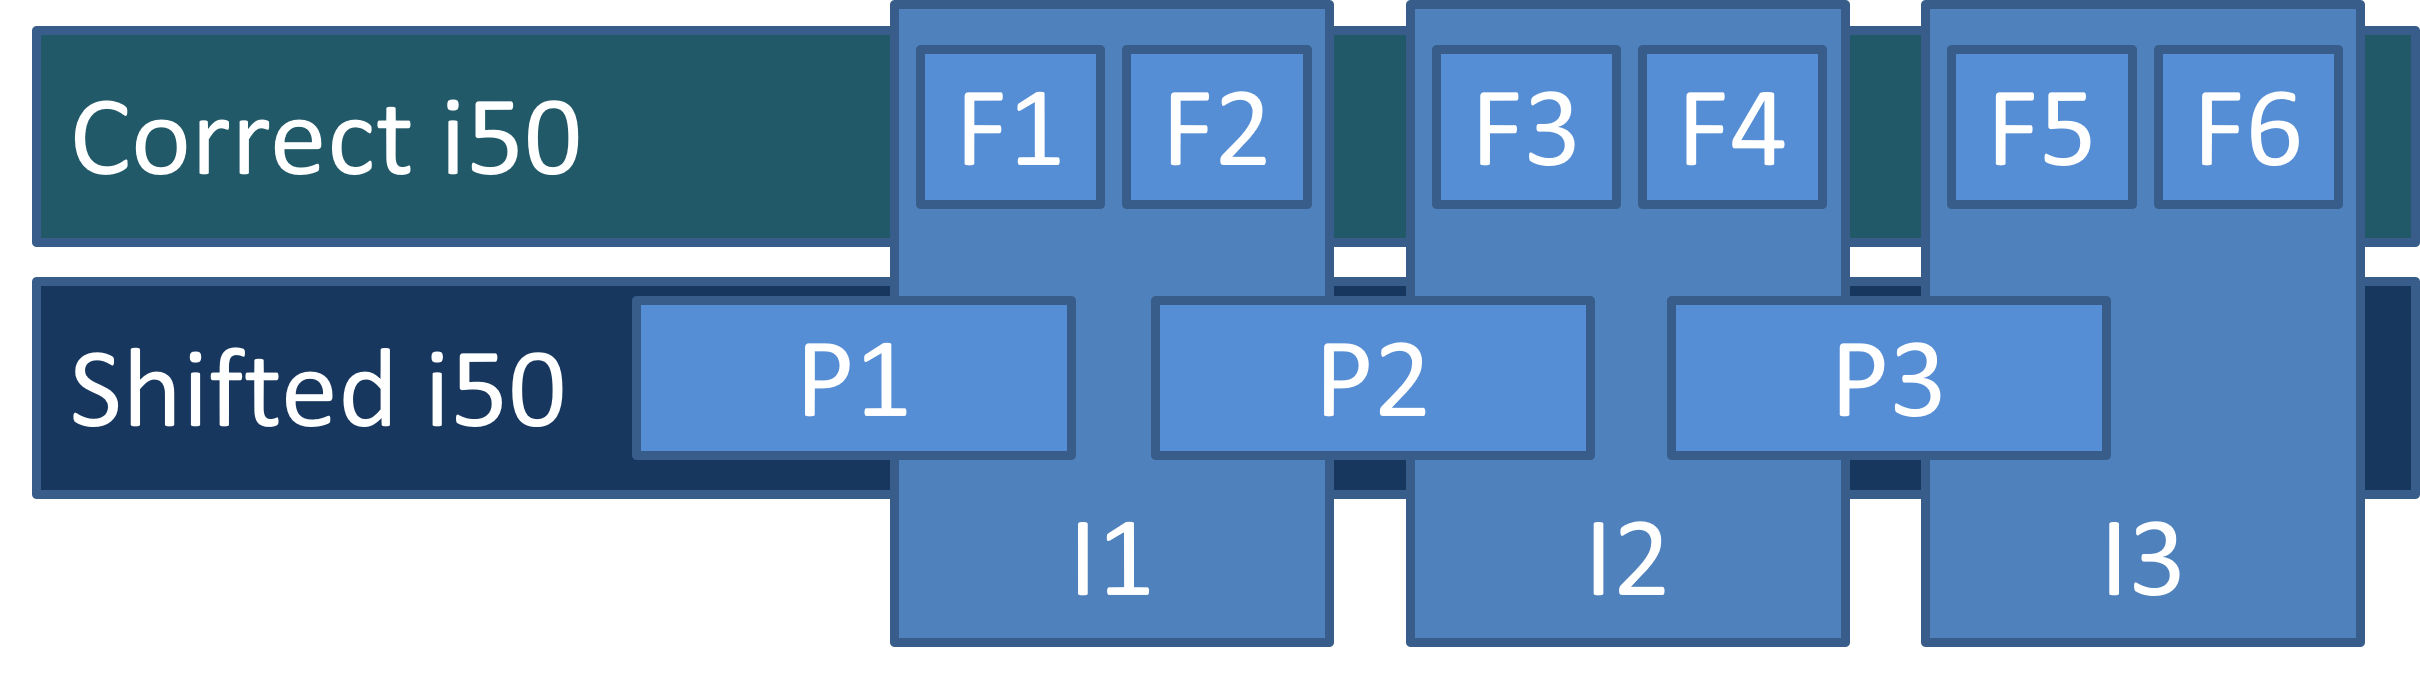
Рассмотрим подробнее случай со смещённым интерлейсингом. Обычно такой поток возникает из-за особенностей производственного пайплайна: сначала материал с частотой 25 к/с преобразовали в 50 к/с простым дублированием кадров, а затем снова упаковали в чересстрочный поток, но со смещением на одно поле. В результате каждый чересстрочный кадр потока содержит поля двух соседних прогрессивных кадров исходного видеоряда.
Детектор чересстрочности определяет такие кадры как чересстрочные. Однако если просто выполнить деинтерлейсинг и восстановить поток p50, обнаружится, что ожидаемой плавности нет: полученные кадры оказываются практически одинаковыми попарно.
Восстановление из Shifted p25
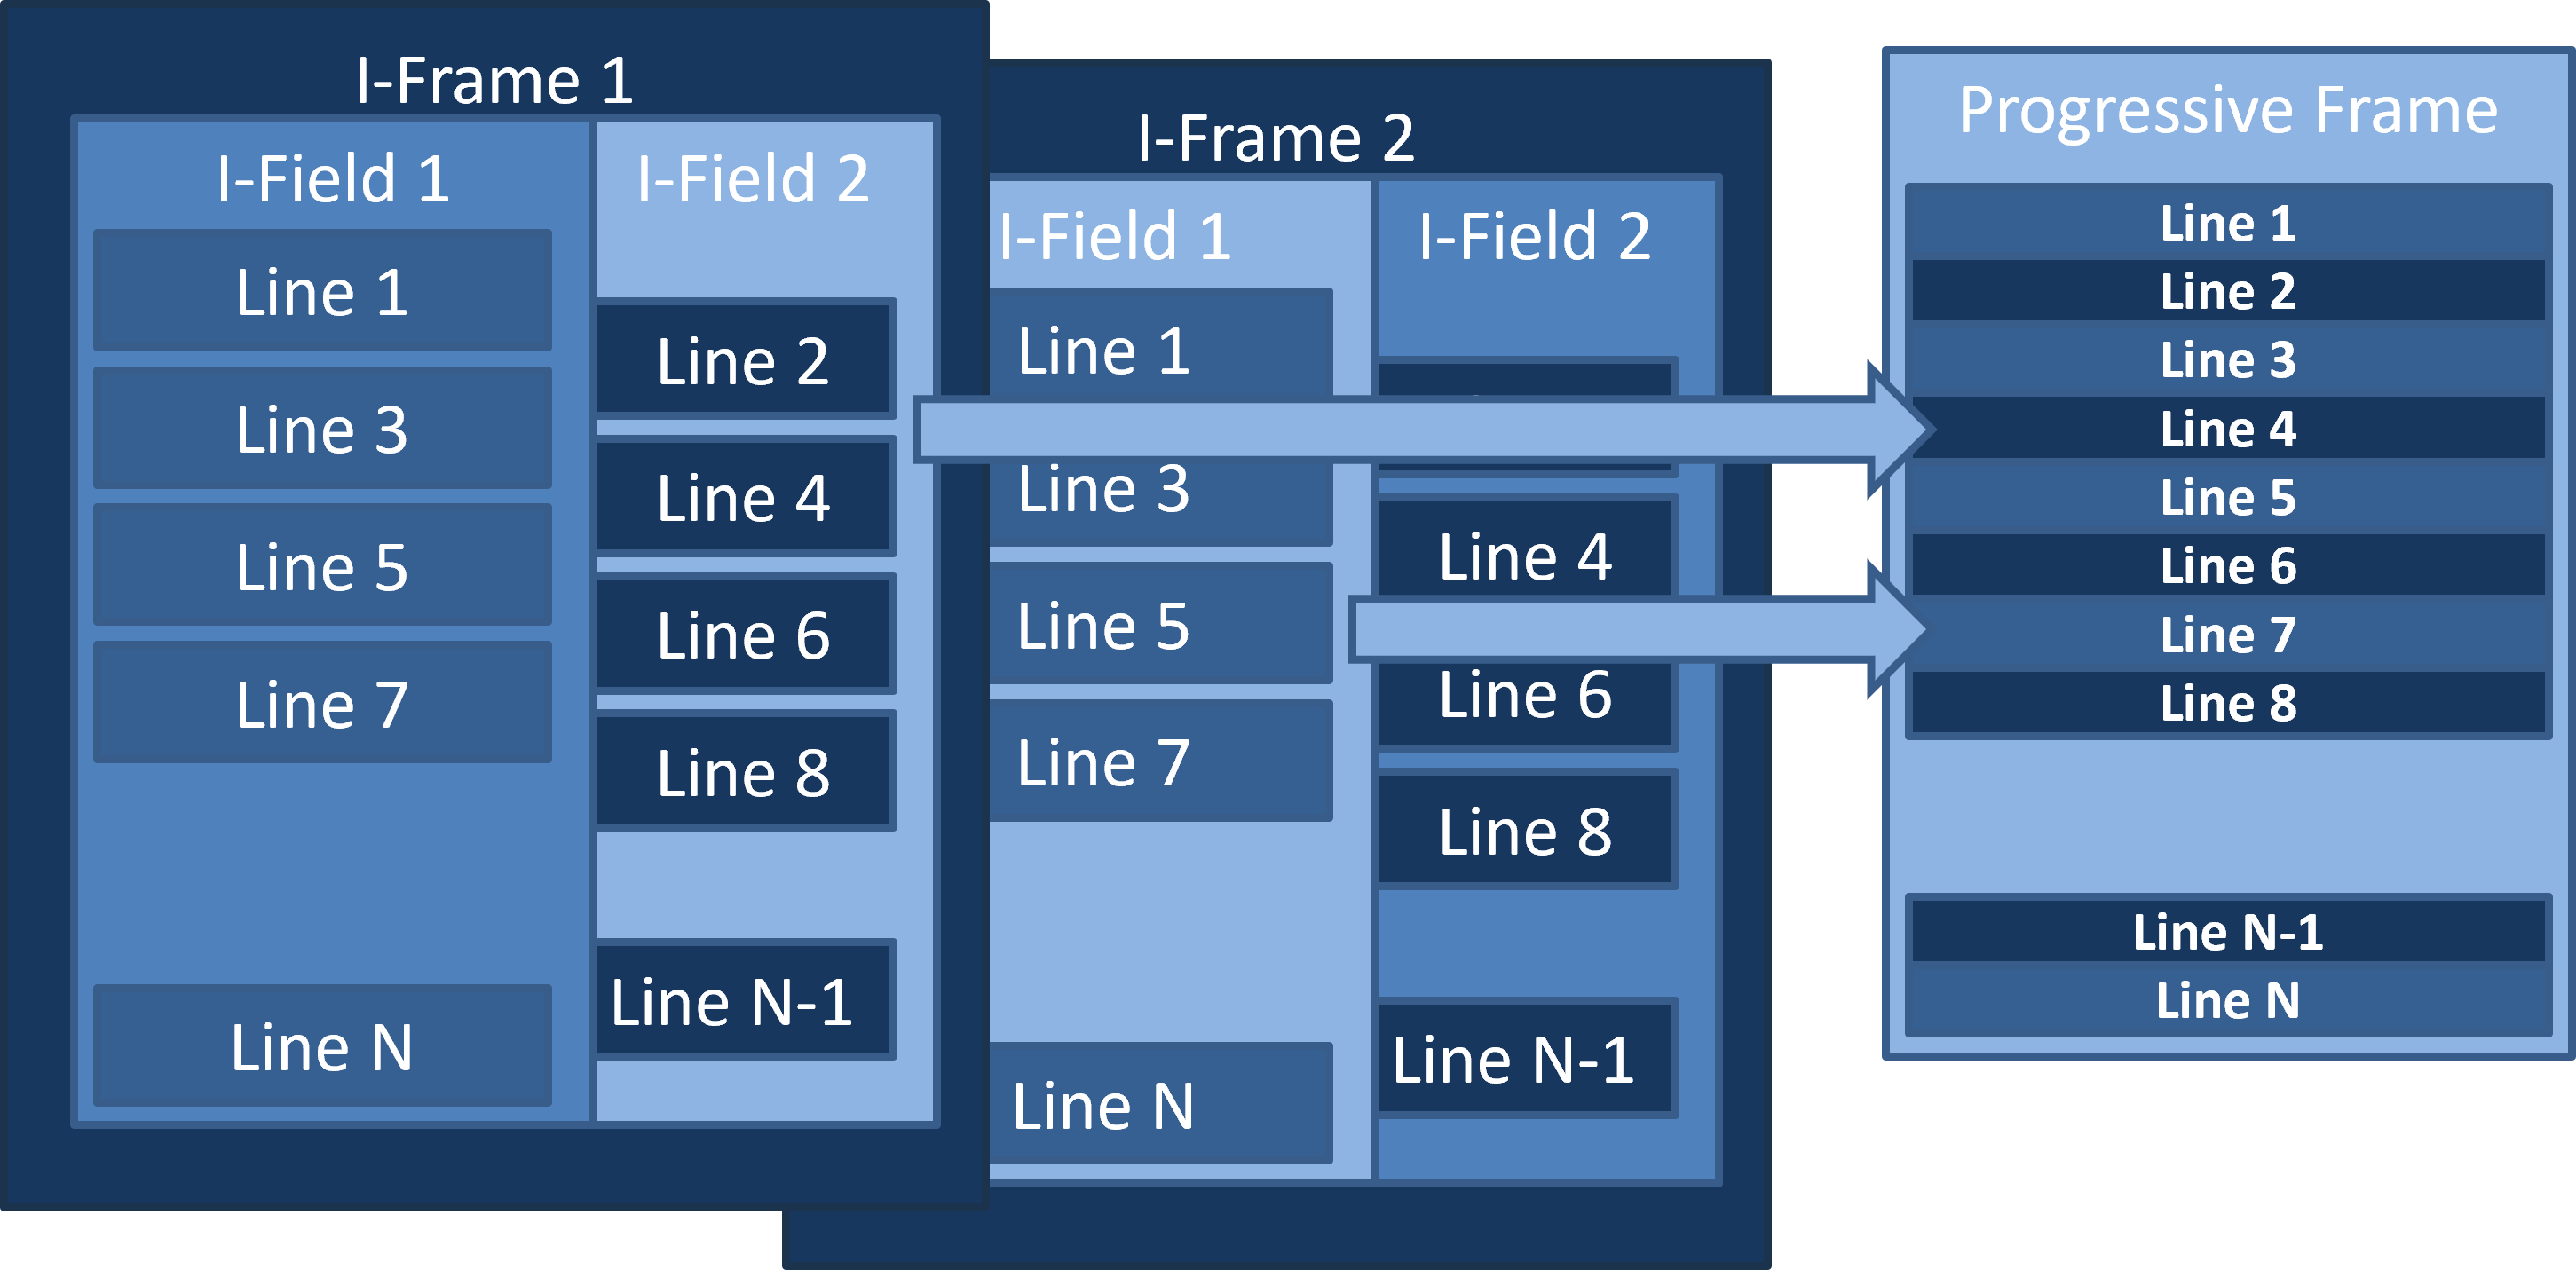
Для корректной обработки такого потока после обнаружения чересстрочности попробуем собрать пробный кадр из чётных строк текущего чересстрочного кадра и нечётных строк следующего чересстрочного кадра.
Если детектор не обнаруживает в пробном кадре признаков чересстрочности, значит, это наш случай. Вместо сложной эвристической обработки мы просто выдаём собранный кадр в качестве результата.
Полный деинтерлейсинг
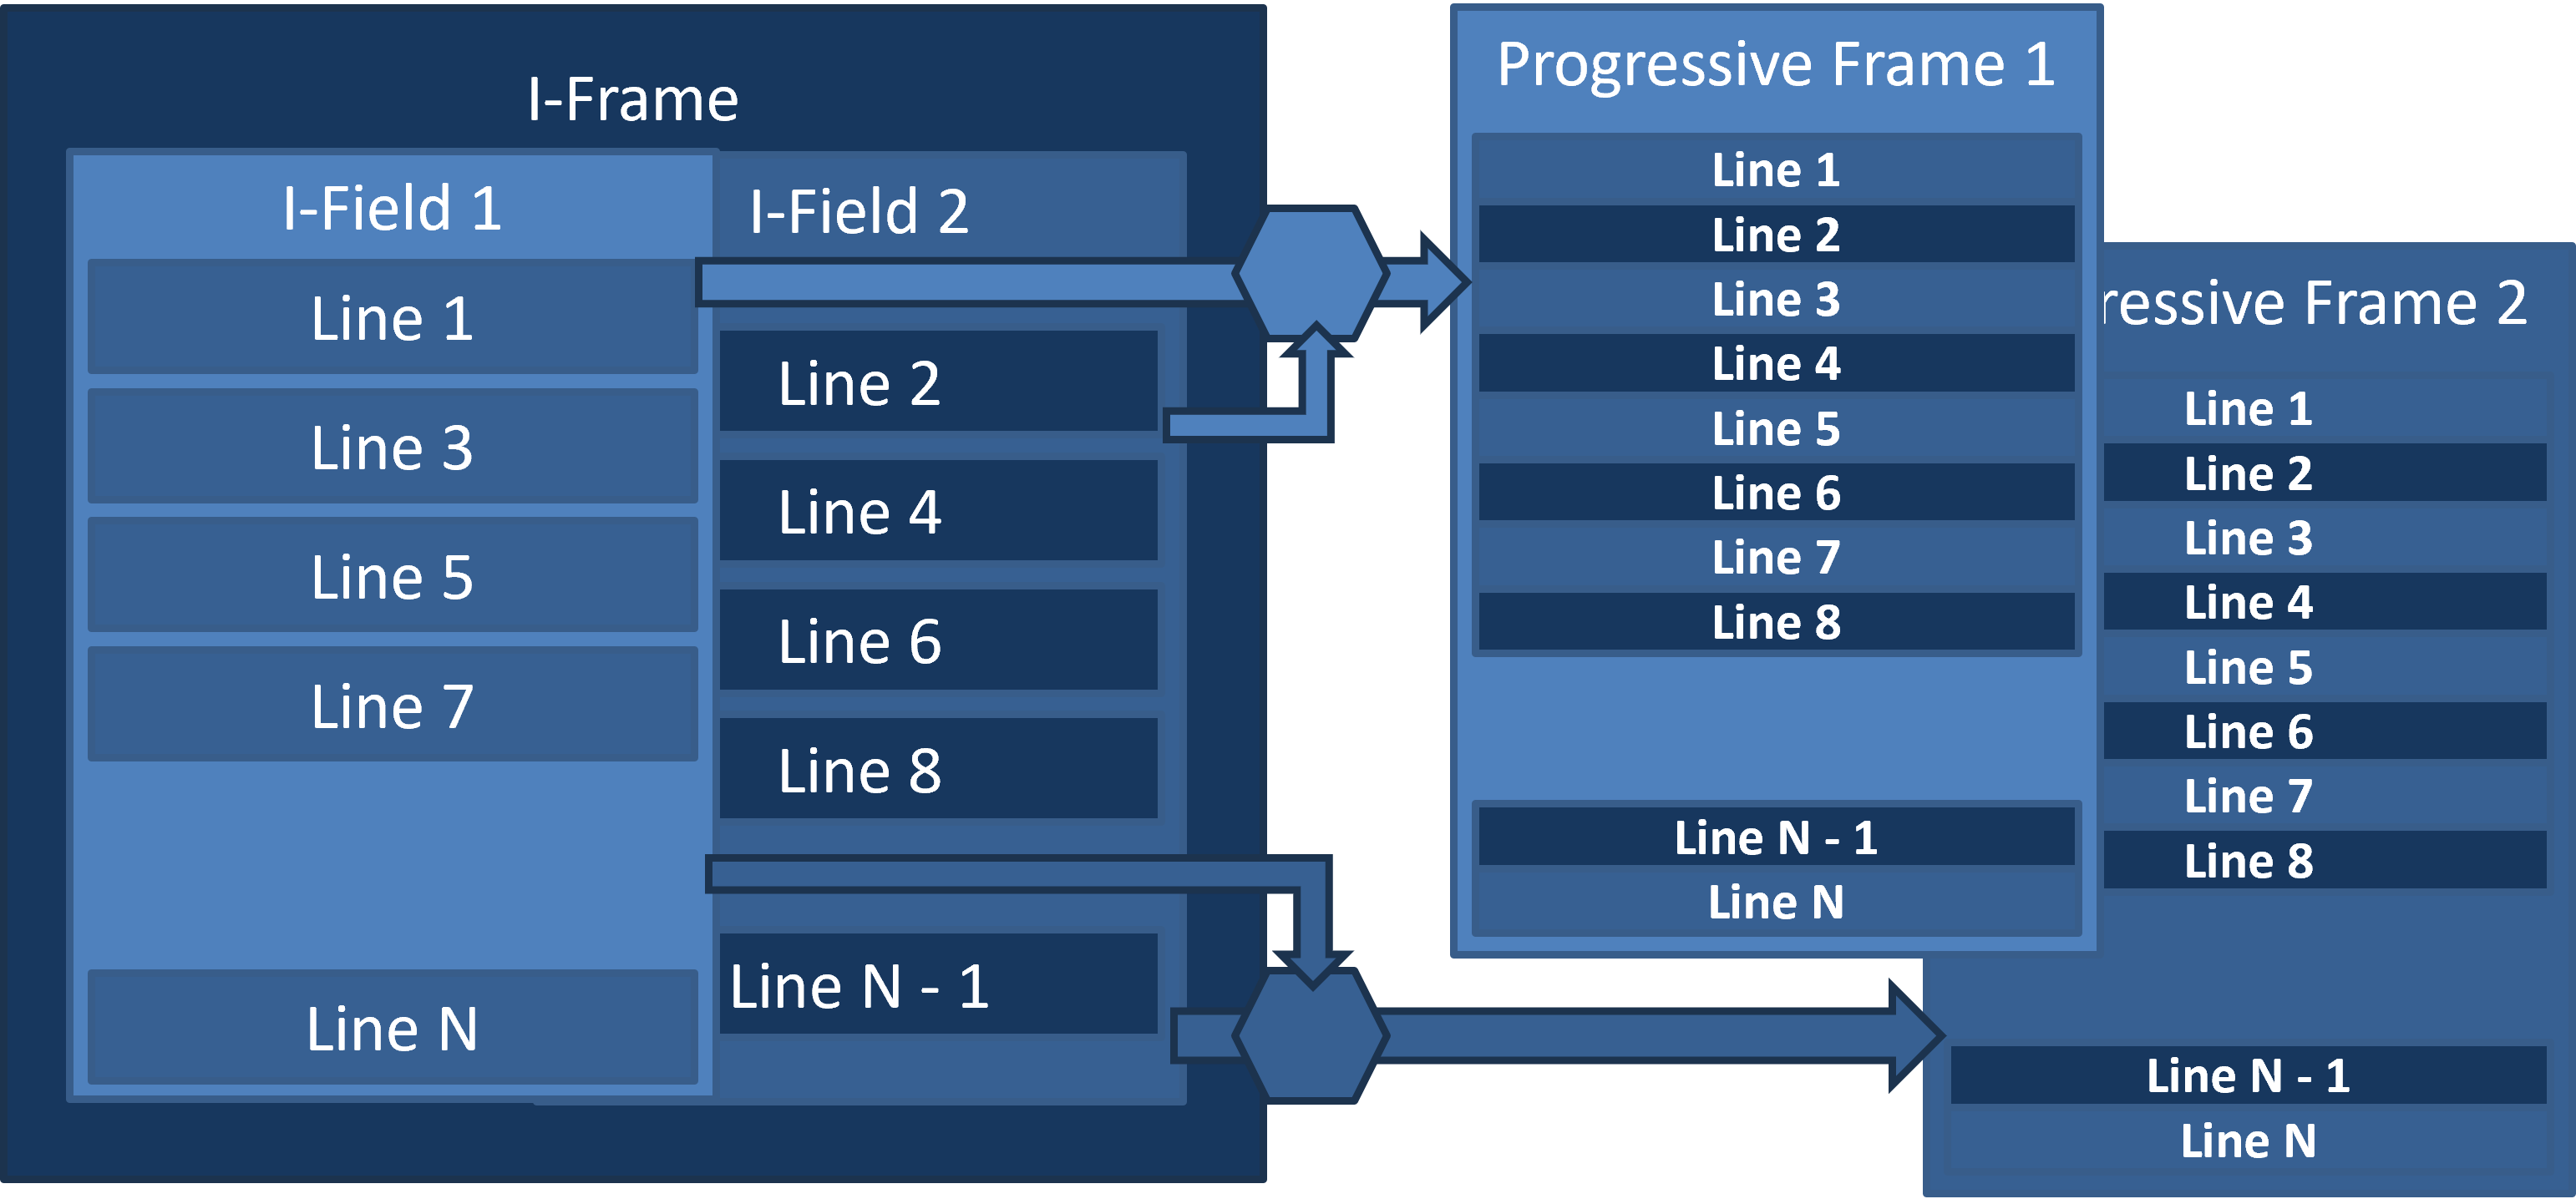
В случае, когда кадр однозначно определён как чересстрочный, необходимо применять полную процедуру деинтерлейсинга.
Процедура заключается в построении прогрессивного кадра из двух чересстрочных полей — основного и вспомогательного. Вспомогательное поле используется для восстановления пространственных деталей изображения.
В режиме синтеза p25 из каждого чересстрочного кадра строится только один прогрессивный кадр за один проход. Первое поле (нечётные строки) используется как основное, второе поле (чётные строки) — как вспомогательное.
В режиме синтеза p50 из каждого чересстрочного кадра строятся два прогрессивных кадра за два прохода. Первый прогрессивный кадр строится так же, как в режиме p25. Второй прогрессивный кадр строится наоборот: в качестве основного берётся второе поле, а в качестве вспомогательного — первое. На практике в целях оптимизации на самом деле два прохода объединяются, но математически это неважно.
На практике наряду с описанным порядком полей (top field first) встречается и обратный (bottom field first). Порядок полей задаётся настройкой фильтра.
Полное построение прогрессивного кадра
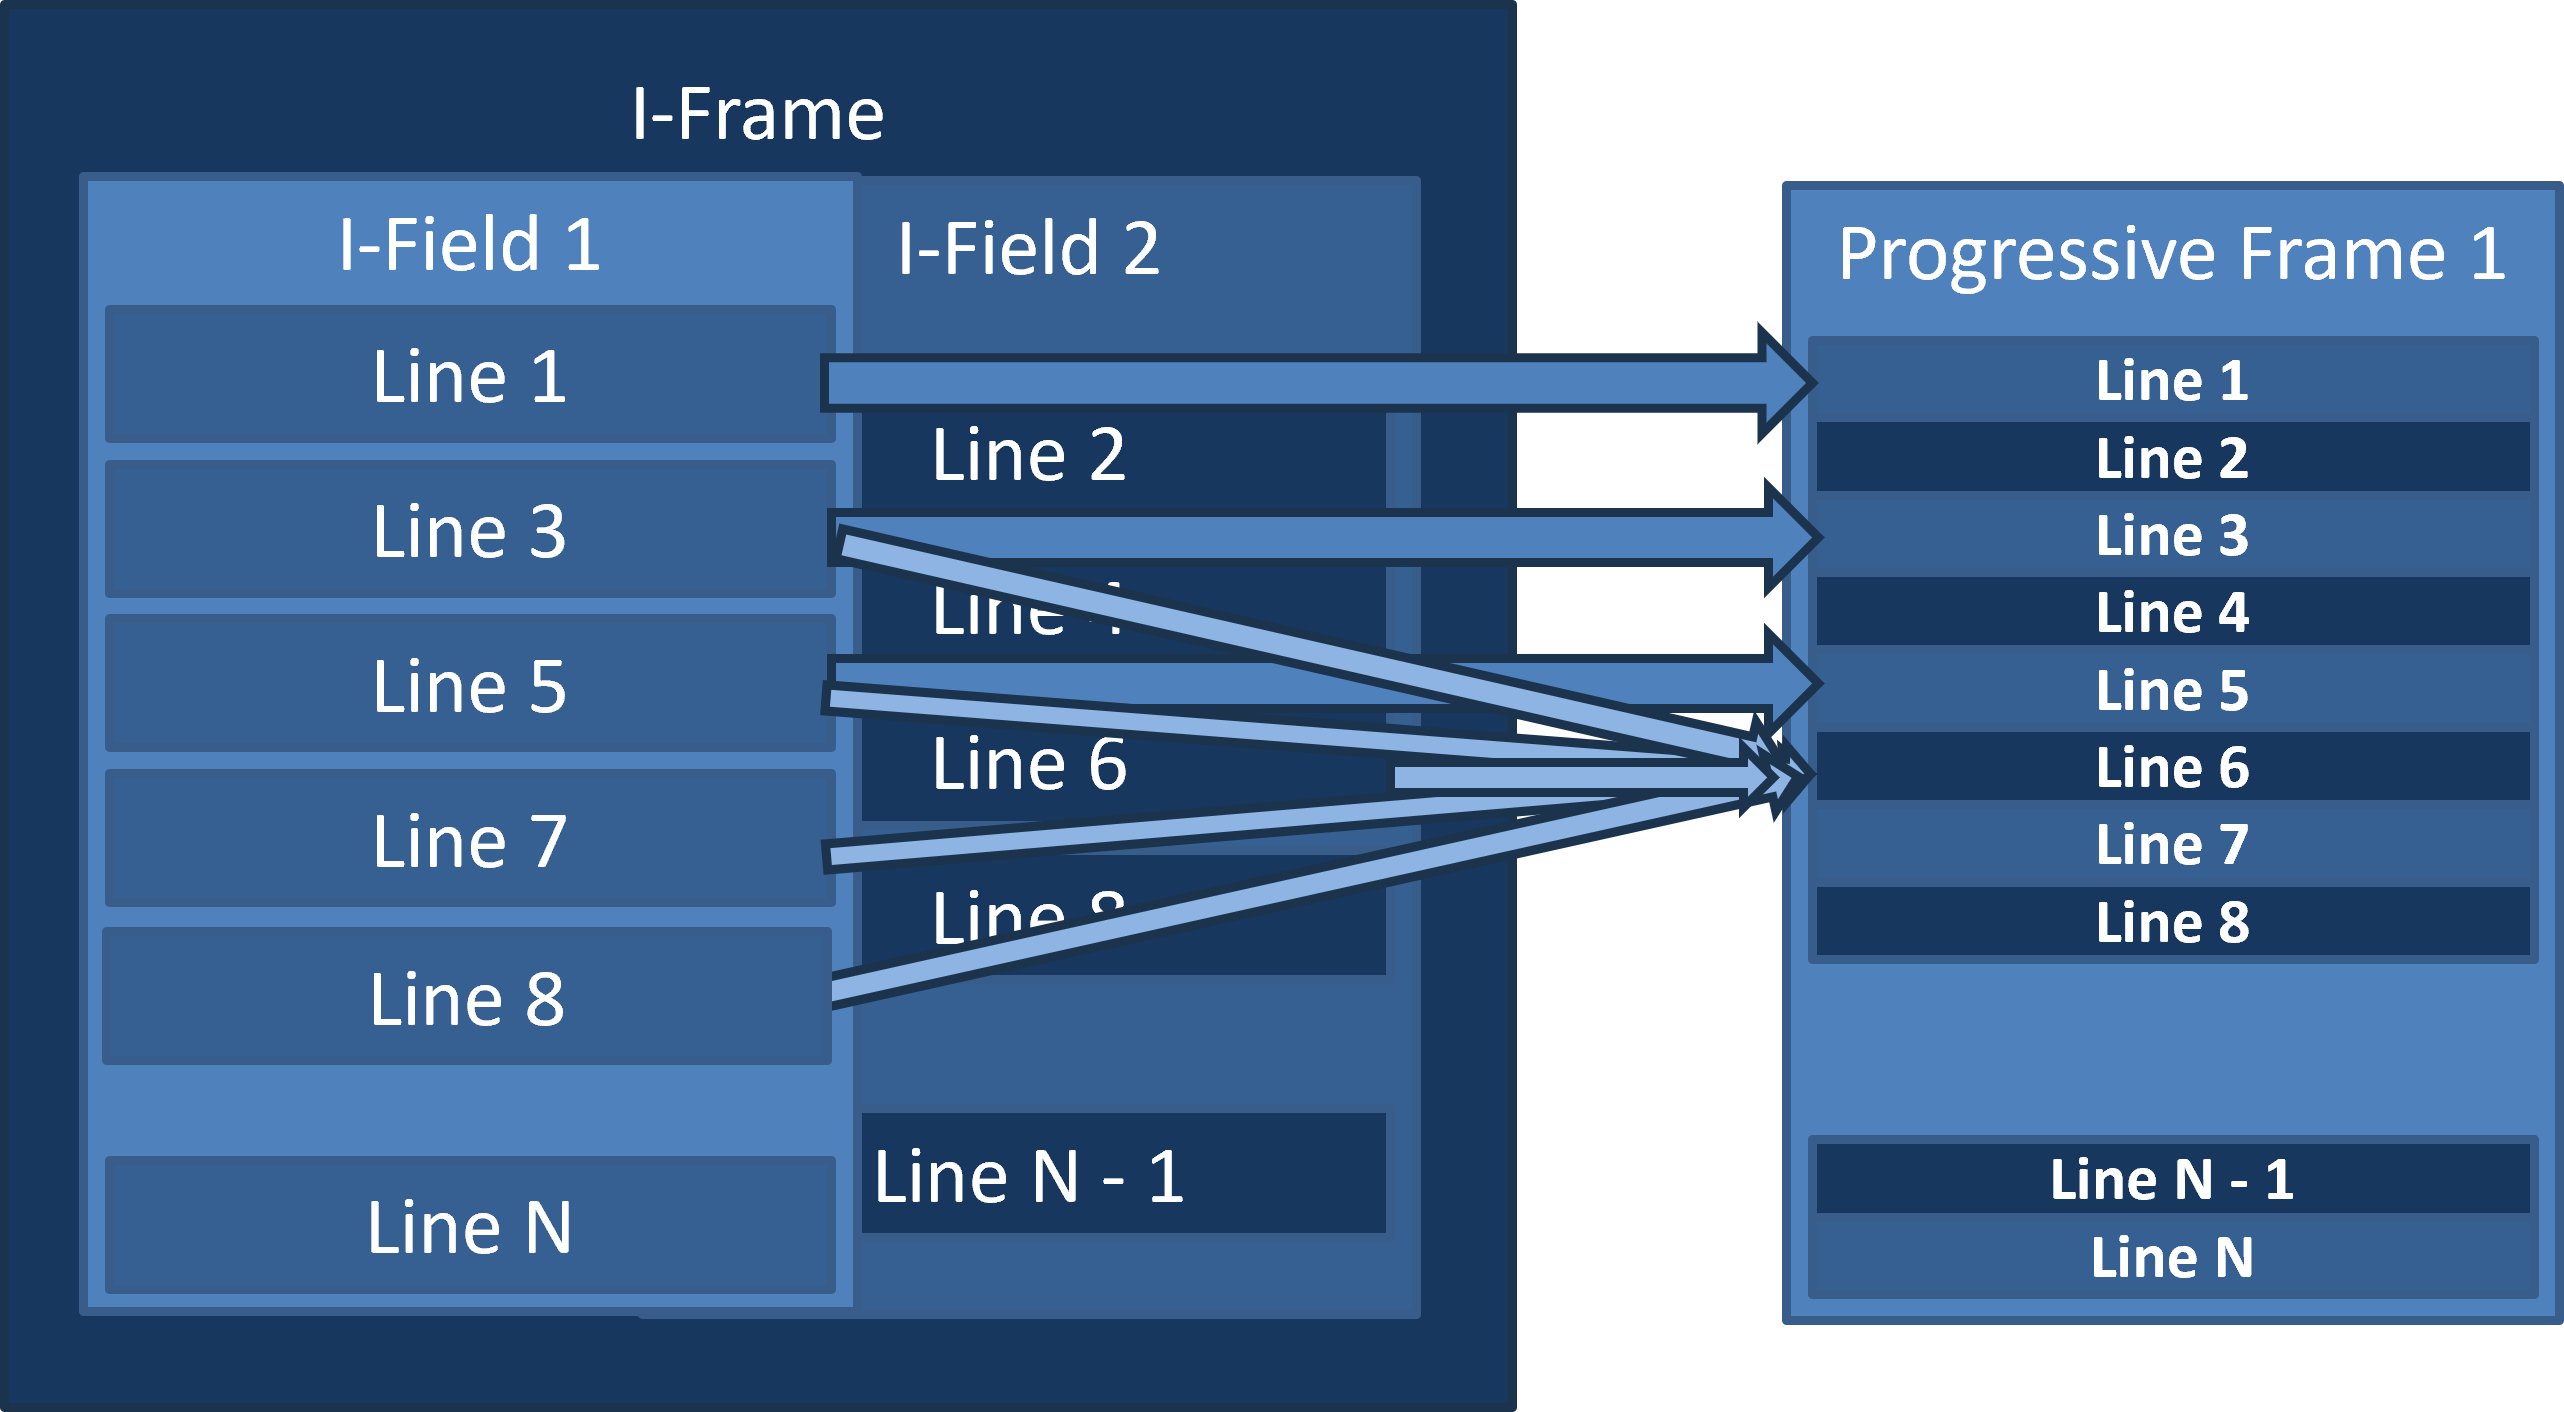
Копирование строк основного поля без изменений позволяет последовательно применять фильтры deinterlacing/interlacing, не накапливая вычислительных ошибок в этих строках.
При построении недостающих строк необходимо убить двух зайцев. В динамичных сценах следует интерполировать соседние строки основного поля с учётом движения в кадре. В областях с низкой динамикой нужно использовать данные вспомогательного поля для увеличения вертикального разрешения изображения, поскольку эти данные получены из точек, смещённых по вертикали.
Как бить зайцев?
Сейчас немного углубимся в математику восстановления изображения. Если этот раздел покажется читателю слишком сложным или просто скучным, его можно пропустить.
Алгоритм использует три последовательных чересстрочных кадра: предыдущий I₋₁, текущий I₀ и следующий I₊₁. Для каждого входного кадра формируются два выходных прогрессивных кадра, соответствующих двум полям. Предполагается порядок полей TFF (Top Field First) — верхнее поле предшествует нижнему.
1. Пространственная интерполяция
Пусть (x, y) — координаты восстанавливаемого пикселя. Начальное значение определяется как среднее двух вертикально соседних пикселей текущего кадра:
Для сохранения диагональных границ выполняется поиск наиболее согласованного направления интерполяции. Рассматриваются горизонтальные смещения j ∈ {-2, -1, 0, 1, 2}.
Для каждого смещения вычисляется сумма абсолютных разностей между тремя парами пикселей, расположенных по разные стороны восстанавливаемой строки:
Выбирается направление с минимальной ошибкой согласования:
Пространственное предсказание определяется средним значением пикселей вдоль выбранного направления:
2. Временное предсказание
Для оценки временной согласованности используются значения пикселей из двух кадров A и B. Их выбор зависит от обрабатываемого поля: для первого поля A = I₋₁, B = I₀; для второго поля A = I₀, B = I₊₁.
Центральное временное предсказание вычисляется как:
Начальная допустимая величина отклонения определяется максимальным из трёх показателей временных различий:
3. Временное ограничение
Дополнительно вычисляются временные предсказания для пикселей, расположенных на две строки выше и ниже восстанавливаемого пикселя:
Здесь B_t и F — верхнее и нижнее временные предсказания. Для краткости обозначим значения соседних строк:
Вычисляются верхняя и нижняя оценки отклонения:
Допустимое отклонение расширяется с учётом полученных оценок:
Окончательный результат пространственно-временной интерполяции ограничивается интервалом вокруг временного предсказания:
Полученное значение дополнительно ограничивается диапазоном [0, 1].
4. Оценка движения
Для сохранения исходной детализации на неподвижных участках вычисляется локальная оценка движения с использованием окна размером 5×5 пикселей.
Вертикальная координата центра окна округляется вниз до ближайшей чётной строки. Благодаря этому для двух строк одной пары используется общий центр оценки движения.
Для каждого пикселя окна определяется максимальная разность между текущим кадром и соседними по времени кадрами:
Итоговая оценка движения равна среднему значению этих разностей по всему окну:
5. Адаптивное смешивание
Коэффициент смешивания определяется оценкой движения с помощью функции smoothstep. Используются два пороговых значения: a = 0.004 и b = 0.020.
На неподвижных участках коэффициент w близок к нулю, поэтому сохраняется исходный пиксель текущего чересстрочного кадра. При обнаружении движения коэффициент увеличивается, отдавая предпочтение пространственно-временной интерполяции.
Окончательное значение восстанавливаемого пикселя:
Таким образом, алгоритм сочетает сохранение исходных значений пикселей на статичных участках (Weave) с направленной пространственно-временной интерполяцией (YADIF) на участках с движением.
Оптимизация
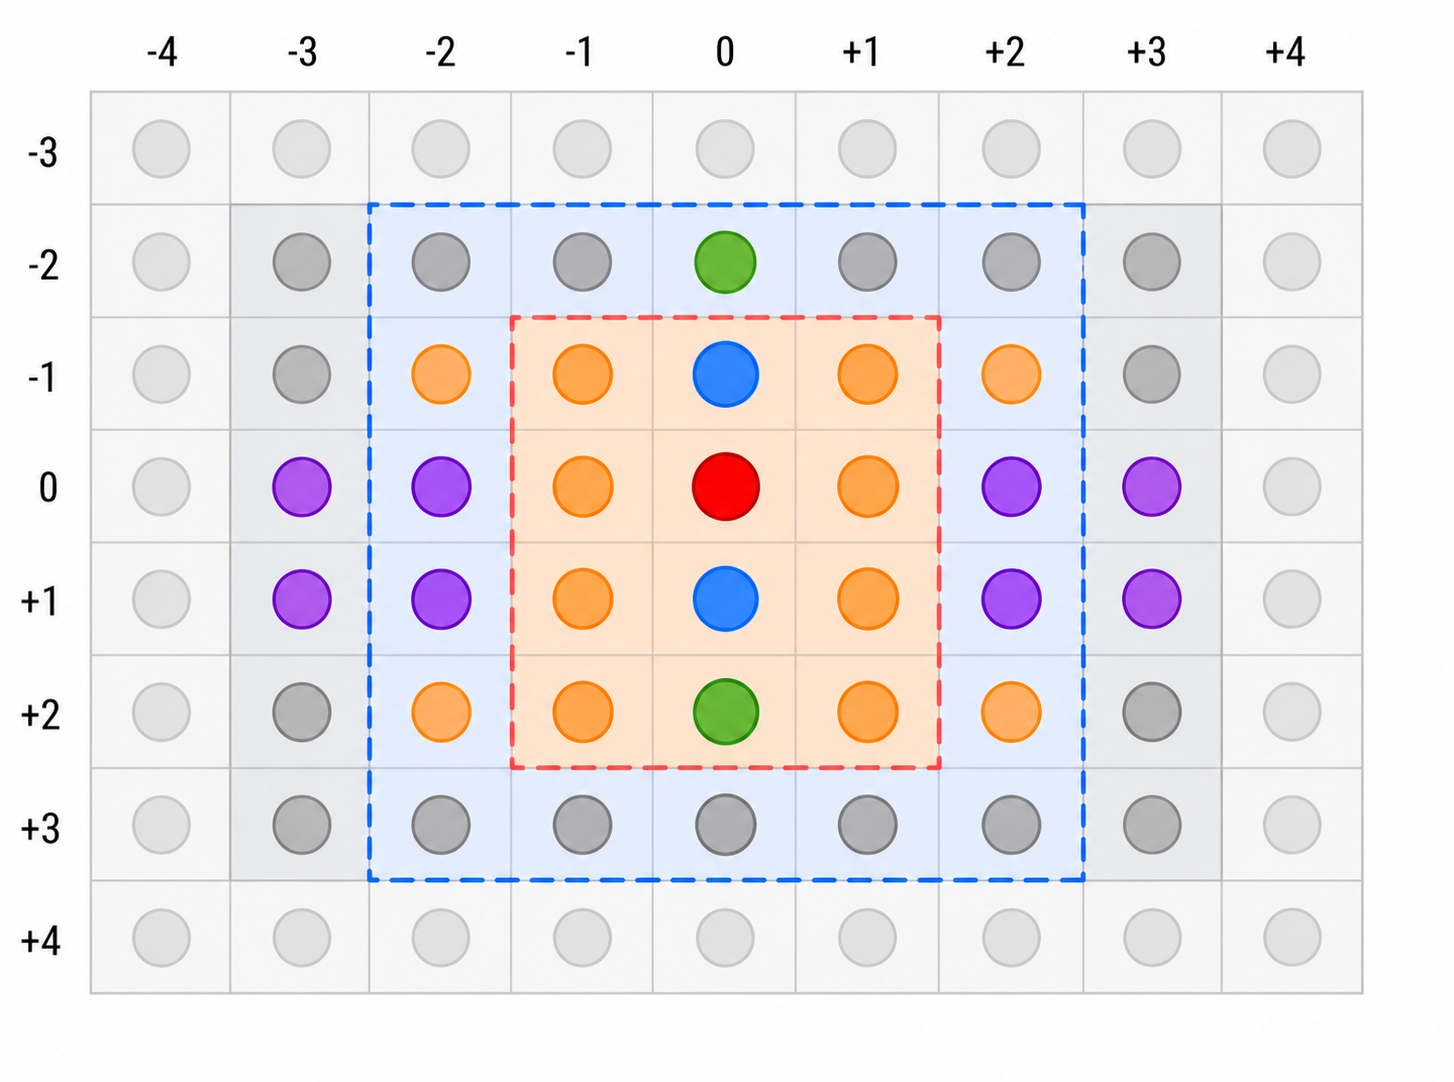
На схеме показана окрестность восстанавливаемого пикселя и области, используемые для пространственно-временной интерполяции YADIF и обнаружения движения.
- Красный — восстанавливаемый пиксель.Координаты (x, y). Значение вычисляется с помощью пространственно-временной интерполяции и смешивается с исходным значением в зависимости от оценки движения.
- Синий — вертикальные соседи.Пиксели (x, y−1) и (x, y+1) текущего кадра. Используются для начальной интерполяции, поиска направления и оценки временных различий.
- Зелёный — временные ограничения YADIF.Позиции (x, y−2) и (x, y+2) в соответствующей паре кадров. Используются для уточнения допустимого диапазона восстановленного значения.
- Фиолетовый — поиск направления.Дополнительные пиксели для сравнения диагональных направлений интерполяции. Поиск выполняется на строках y−1 и y+1 со смещениями j = −2, −1, +1, +2.
- Оранжевый — дополнительные пиксели.Пиксели центральной окрестности, часть которых участвует в направленном поиске YADIF, а часть — в оценке движения.
- Тёмно-серый — окружающие пиксели.Пиксели расширенной окрестности. Некоторые из них используются детектором движения в зависимости от чётности восстанавливаемой строки.
- Светло-серый — внешняя область.Пиксели за пределами показанной основной области обработки.
Области обработки
- Красная пунктирная рамка.Условно выделяет центральную окрестность пикселя. Не соответствует отдельному окну в шейдере.
- Синяя пунктирная рамка.Показывает расширенную окрестность. Реальное окно оценки движения имеет размер 5×5 пикселей и центрируется по ближайшей чётной строке, не превышающей координату восстанавливаемого пикселя.
Если аккуратно использовать Compute-шейдеры и SharedMemory, то значительно пересечение областей пикселей можно закешировать в быстрой памяти GPU. Кроме того, можно строить оба кадра за один проход, экономя на алгоритме поиска.
Из нашего опыта при программировании подобных Compute-шейдеров хорошо себя показывает обработка сразу нескольких destination-пикселей в каждом GPU-потоке, что позволяет использовать широкую областьв каждом ThreadGroup.
Основной Код — загрузка текстур в Shared Memory
Texture2D<S> source0 : register(t0);
Texture2D<S> source1 : register(t1);
Texture2D<S> source2 : register(t2);

SComputeConstantsP g : register(b0);

static const int g_N = 32;  // number of X-threads per group
static const int g_MT = 4;  // number of Y-threads per group
static const int g_MX = 3;  // number of Y-multiplicator

static const int g_M = g_MT*g_MX;

static const int2 lblock2 = int2(g_N, g_M*2);

S readSource(int index, int2 pos)
{
    pos.x = clamp(pos.x, 0, (int) g.size_x - 1);
    pos.y = clamp(pos.y, 0, (int) g.size_y - 1);
    return (index == 0) ? source0[pos] :
            (index == 1) ? source1[pos] : source2[pos];
}

static const int sizeX = g_N + 6;       // group area X-size
static const int sizeY = g_M*2 + 5;     // group area Y-size

static const int pitchX = g_N + 8;
static const int pitchY = sizeY*pitchX;

groupshared S shared_data[3][pitchY];

S readArray(int index, int x, int y)
{
    return shared_data[index][y * pitchX + x];
}
void writeArray(int index, int x, int y, S d)
{
    shared_data[index][y*pitchX + x] = d;
}

S read(int index, int2 pos, int2 posx)
{
    int2 d = pos - posx;
    return readArray(index, d.x, d.y);
}
void preload(int2 delta, int2 posx)
{
[unroll] for (int index = 0; index < 3; index++)
{
S d0 = readSource(index, delta + posx + int2(0, 0));
writeArray(index, delta.x, delta.y, d0);
}
}
void preloadGroup(int2 ithread, int2 posx)
{
const int maxyMT = sizeY/g_MT;
int iy;
for (iy = 0; iy < maxyMT; iy++)
{
int2 pos = int2(ithread.x, (ithread.y + iy*g_MT));
preload(pos, posx);
}
const int extrapix = sizeY*8;
const int extray = (extrapix + g_N - 1)/ (g_N);
const int extrayMT = (extray + g_MT - 1) / g_MT;
for (iy = maxyMT; iy < maxyMT + extrayMT; iy++)
{
int2 pos = int2(ithread.x, ithread.y + iy*g_MT);
[flatten] if (pos.y >= sizeY)
{
// extra field
int i = (pos.y - sizeY)*g_N + pos.x;
pos.x = g_N + (i & 7);
pos.y = (i >> 3);
}
[branch]
if ((pos.x < sizeX) && (pos.y < sizeY))
{
preload(pos, posx);
}
}
GROUP_SYNC
}
Здесь показан пример совместной загрузки прямоугольной области из трёх текстур в Shared Memory GPU. Каждый поток загружает несколько пикселей, распределяя работу между потоками одной ThreadGroup. Помимо основной области обработки, загружаются дополнительные пиксели по краям, необходимые для интерполяции вблизи границ блока. Шаг строк в Shared Memory немного больше фактической ширины данных, что обеспечивает дополнительный отступ при размещении пикселей в памяти. После завершения загрузки выполняется синхронизация потоков, чтобы все данные были доступны перед началом вычислений. Благодаря этому соседние выходные пиксели могут повторно использовать уже загруженные данные, не обращаясь каждый раз к исходным текстурам.
Основной Код — построение
S processYADIF(int2 pos, SContext context, int odds)
{
    int2 dx = int2(1, 0); int2 dy = int2(0, 1);

    bool secondField = (odds == 0);
    S p2 = read(secondField ? 0 : 1, pos, context);
    S n2 = read(secondField ? 2 : 0, pos, context);

    S t = (p2 + n2) * 0.5;
    S c = read(0, pos - dy, context);
    S e = read(0, pos + dy, context);

    S diff0 = abs(p2 - n2) * 0.5;
    S diff1 = (abs(read(1, pos - dy, context) - c) +
                abs(read(1, pos + dy, context) - e)
    ) * 0.5;
    S diff2 = (abs(read(2, pos - dy, context) - c) +
                abs(read(2, pos + dy, context) - e)
    ) * 0.5;
    S diff = max(diff0, max(diff1, diff2));

    S spatial = (c + e) * 0.5;
    S score = abs(read(0, pos - dy - dx, context) -
                  read(0, pos + dy - dx, context)) +
              abs(c - e) +
              abs(read(0, pos - dy + dx, context) -
                  read(0, pos + dy + dx, context));

    [unroll] for (int j = -2; j <= 2; j++) {
        if (j == 0) continue;
        int2 shift = int2(j, 0);
        S a0 = read(0, pos - dy + shift - dx, context);
        S a1 = read(0, pos - dy + shift, context);
        S a2 = read(0, pos - dy + shift + dx, context);
        S b0 = read(0, pos + dy - shift - dx, context);
        S b1 = read(0, pos + dy - shift, context);
        S b2 = read(0, pos + dy - shift + dx, context);
        S s = abs(a0 - b0)
                + abs(a1 - b1)
                + abs(a2 - b2);
        compare(s, score, spatial, (a1 + b1) * 0.5);
    }

    S b = (read(secondField ? 0 : 1, pos - 2 * dy, context) +
            read(secondField ? 2 : 0, pos - 2 * dy, context)
    ) * 0.5;
    S f = (read(secondField ? 0 : 1, pos + 2 * dy, context) +
            read(secondField ? 2 : 0, pos + 2 * dy, context)
    ) * 0.5;
    S upper = max(max(t - e, t - c), min(b - c, f - e));
    S lower = min(min(t - e, t - c), max(b - c, f - e));

    diff = max(diff, max(lower, -upper));
    return saturate(clamp(spatial, t - diff, t + diff));
}
struct SContext
{
    int2 posx;
};

S process(int2 pos, SContext context, int odds)
{
    S bob = processYADIF(pos, context, odds);
    S weave = read(0, pos, context);

    int2 base = int2(pos.x, pos.y & ~1);
    S motion = zero;
    [unroll] for (int y = -2; y <= 3; y++) {
        [unroll] for (int x = -2; x <= 2; x++) {
            int2 p = base + int2(x, y);
            S prev = read(1, p, context);
            S cur = read(0, p, context);
            S next = read(2, p, context);
            S d = max(abs(prev - cur), abs(next - cur));
            motion = max(motion, d);
        }
    }
    S weight = smoothstep(0.008, 0.025, motion);
    return lerp(weave, bob, weight);
}

[numthreads(g_N, g_MT, 1)]
void CS(uint3 Gid : SV_GroupID,             // thread group id
        uint3 DTid : SV_DispatchThreadID,   // absolute thread position
        uint3 GTid : SV_GroupThreadID,      // thread position in thread group
        uint GI : SV_GroupIndex)            // thread group scalar index
{

    int2 iblock = Gid.xy*lblock2;
    int2 posx = iblock - int2(3, 2);
    preloadGroup(GTid.xy, posx);

    SContext context; context.posx = posx;
    for (int y = 0; y < g_MX; y++)
    {
        int2 tid = int2(GTid.x, GTid.y + g_MT*y);
        int2 pos = iblock + int2(tid.x, tid.y * 2);
        {
            int2 dy = int2(0, 1);
            int2 pos0 = pos;
            int2 pos1 = pos + dy;
            if (g.odds == 0) {
                pos1 = pos;
                pos0 = pos + dy;
            }
            dest[pos0] = read(0, pos0, context);
            dest[pos1] = process(pos1, context, g.odds);
        }
    }
}
Здесь показана основная часть алгоритма восстановления. Функция processYADIF вычисляет недостающий пиксель по трём последовательным кадрам. Сначала оцениваются временные различия между соседними кадрами, затем выполняется поиск наиболее согласованного направления пространственной интерполяции, в том числе по диагонали. Это позволяет лучше сохранять наклонные границы объектов.
Полученное пространственное предсказание ограничивается допустимым временным интервалом. Такое ограничение не позволяет интерполированному значению слишком сильно отклоняться от окружающих пикселей и помогает уменьшить артефакты на движущихся участках изображения.
Функция process смешивает результат YADIF с исходным значением пикселя в зависимости от движения. Оценка движения строится по максимальной разности между текущим кадром и соседними по времени кадрами в локальном окне. Функция smoothstepпреобразует эту оценку в коэффициент смешивания: на статичных участках предпочтение отдаётся Weave, а при движении — интерполяции YADIF.
Наконец, Compute-шейдер обрабатывает сразу несколько пар выходных строк в каждом GPU-потоке. Строки исходного поля копируются без изменений, а недостающие восстанавливаются. Перед вычислениями потоки одной ThreadGroup совместно загружают необходимую область текстур в Shared Memory, благодаря чему соседние пиксели могут повторно использовать закешированные данные.
Заключение
Мы начали с задачи, которая на первый взгляд кажется довольно простой: преобразовать чересстрочное видео в прогрессивное. Но на практике в одном видеопотоке могут встречаться прогрессивные и чересстрочные кадры, дублированные кадры, смещённые поля и переходы между разными режимами. Если применять деинтерлейсинг без разбора, можно испортить даже совершенно нормальное прогрессивное изображение.
Поэтому наш фильтр сначала анализирует входное видео и выбирает подходящий способ обработки. Прогрессивное изображение сохраняется без изменений, смещённые поля по возможности объединяются, а действительно чересстрочные кадры восстанавливаются с адаптацией к движению.
Само восстановление сочетает несколько подходов: сохранение исходного поля, поиск оптимального направления интерполяции, временные ограничения и смешивание результата в зависимости от движения. Это позволяет сохранять мелкие детали на статичных участках и уменьшать гребёнку и мерцание в динамичных сценах.
Наконец, качество изображения — лишь половина задачи. Не менее важна производительность. Compute-шейдеры, Shared Memory, совместная загрузка текстур и обработка нескольких пикселей одним GPU-потоком позволяют повторно использовать данные и сокращать обращения к памяти. Благодаря этим оптимизациям такой подход подходит для обработки видео в реальном времени.